| TH—NEWS |
Morning Digest — 2026-10-06
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 에이전트 평가·편향 같은 연구 읽을거리와, 바로 써볼 수 있는 Claude 확장/번역 워크플로가 같이 들어와서 가볍게 넘기기엔 아까운 날입니다. 당장 손에 잡히는 건
MCPB로 로컬 MCP 서버를 Claude Desktop 원클릭 확장으로 만들기, Translate Book: arXiv - arXiv 논문을 원문 구조 그대로 번역 논문으로 만들어 주는 Claude Code 스킬이고, 업계 감으로는 Beam: Reflection's 501B open-weight model 쪽 반응을 체크할 만합니다.
🔥 꼭 볼 것
| 01 |
로컬 MCP 서버를 Claude Desktop용 원클릭 확장으로 묶는 배포 방식 소개.
💡 MCP 도구를 팀 배포·설치하기 쉬워집니다.
|
| 02 |
 Beam: Reflection's 501B open-weight model Reflection이 501B 규모 오픈웨이트 MoE 모델 Beam 공개를 예고했습니다.
💡 오픈웨이트 대형 모델 판도 변화를 볼 수 있습니다.
|
| 03 |
Source Preference in the Wild: How LLM Agents Favor Items by Source, and How to Reduce It
LLM 에이전트가 출처 자체를 편애하는 현상을 측정하고 완화법을 제안합니다.
💡 검색·추천형 에이전트 신뢰도 개선에 직결됩니다.
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| PyTorch KR | Translate Book: arXiv - arXiv 논문을 원문 구조 그대로 번역 논문으로 만들어 주는 Claude Cod… 어제 | arXiv 논문을 원문 구조 유지 번역본으로 만드는 Claude Code 스킬 소개 |
| HF Papers | On-Policy Parameter Update Direction Underlies Generalization in LLM … | LLM 포스트트레이닝 일반화를 가르는 핵심 요인으로 on-policy 업데이트 방향 제시 |
| HF Papers | HyperBrowseComp: A Multilingual and Multimodal Stress Test for Web-Br… | 웹 브라우징 에이전트의 다국어·멀티모달 한계 점검용 스트레스 테스트 |
| AI Lab Blogs | Our approach to EU text provenance rules | EU 텍스트 출처 규정 대응용 워터마킹·탐지 접근 정리 |
| Simon Willison's Weblog | Qwen3.8 27B addition in words 어제 | Qwen3.8-27B의 대수 덧셈·영문 답변 능력과 추론 효과 점검 |
| r/LocalLLaMA (Top Today) | How is it possible that qwen 27b is so good? When GPT 4o had a trilli… | Qwen 27B 성능 체감과 GPT-4o 파라미터 규모 비교 논의 |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | DuarteSantos8/openGym | 운동 기록·루틴 관리를 내 서버에서 돌리는 셀프호스트 앱 |
📚 전체 목록 (소스별)
GitHub Trending · 1

DuarteSantos8/openGym
JavaScript · 1,444 stars today · ⭐ 4,091
OpenSourceProductivityTooling
TL;DR. 운동 기록·루틴 관리를 내 서버에서 돌리는 셀프호스트 앱
- Docker Compose 한 번으로 설치 가능한 셀프호스트 구조, 광고·구독·텔레메트리 없이 로컬 데이터 소유권 제공
- 1,324개 운동 라이브러리와 요일별 루틴 계획, 슈퍼세트·워밍업·드롭세트·카디오·디로드 등 상세 기록 지원
- 오프라인 동작과 기기 간 동기화, 패스키 로그인, 동시 수정 병합, FitNotes·Strong·Hevy·Apple Health 데이터 가져오기 지원
왜 중요한가 운동 관리 앱의 핵심 데이터를 SaaS가 아닌 개인 서버에 두면서도, 오프라인 지원·패스키·동기화 같은 현대적 UX를 유지한 점이 특징이다. 셀프호스트 도구에 AI 코치와 MCP 연동까지 붙여 개인 데이터 기반 확장성을 보여준다.
추천 대상 개인 데이터 통제권을 중시하는 셀프호스트 사용자와 AI 확장형 라이프로그 도구에 관심 있는 개발자
PyTorch KR 읽을거리 · 1
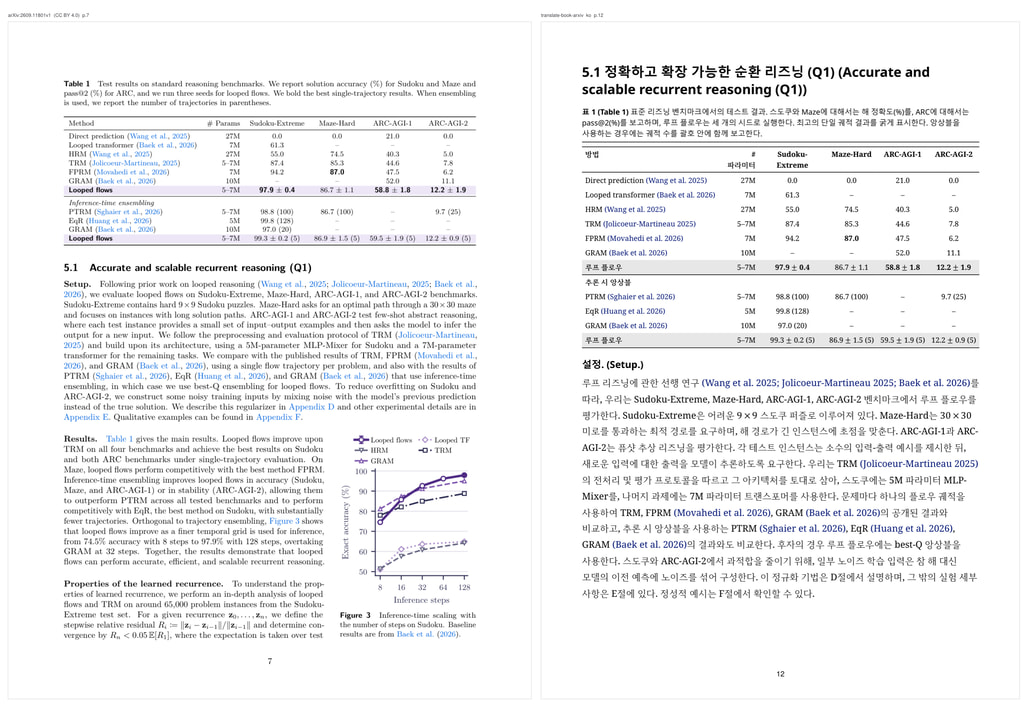
LLMProductivityResearch
TL;DR. arXiv 논문을 원문 구조 유지 번역본으로 만드는 Claude Code 스킬 소개
- arXiv 논문을 입력해 원문 구조를 유지한 번역 논문 형태로 변환하는 Claude Code 스킬 소개
- 단순 본문 번역이 아니라 섹션 구성과 문서 형태를 최대한 보존하는 워크플로우 성격
- 논문 읽기와 번역 문서화 과정을 결합한 활용 사례로 연구 문헌 접근성 개선 목적
왜 중요한가 논문 번역은 내용 정확도뿐 아니라 원문 구조 보존이 중요하다. 이 글은 Claude Code를 활용해 읽기용 번역을 넘어 재구성된 번역 문서 제작 흐름을 제시한다.
추천 대상 영문 arXiv 논문 번역·정리에 Claude Code를 활용하려는 개발자와 연구자
GeekNews 최신 · 1
AgentToolingOpenSource
TL;DR. 로컬 MCP 서버를 Claude Desktop 원클릭 확장으로 패키징하는 MCPB 방식
- Anthropic 공식 문서 기반의 MCPB(.mcpb) 패키징 방식 소개
- 로컬 MCP 서버와 manifest.json을 zip 하나로 묶는 배포 형식
- Claude Desktop에서 브라우저 확장처럼 설치하는 원클릭 확장 흐름
왜 중요한가 MCP 서버를 직접 실행·연결하던 과정을 설치형 패키지로 단순화해 배포성과 사용성을 높이는 접근이다. Claude Desktop 커넥터를 더 쉽게 공유·설치하려는 개발자에게 실용적이다.
추천 대상 Claude Desktop용 MCP 커넥터·로컬 도구 통합을 만들려는 개발자
HuggingFace Daily Papers · 3
AgentLLMResearch
TL;DR. LLM 에이전트의 정보 출처 편향 측정과 완화 방법 제시
- LLM 에이전트가 콘텐츠 품질 외에 출처(source) 자체를 기준으로 항목을 선호하는 현상 분석
- 현실 환경(in the wild)에서 발생하는 출처 선호 편향을 정량적으로 관찰하는 연구 설정 제시
- 에이전트 선택 결과의 왜곡을 줄이기 위한 출처 편향 완화 접근법 제안
왜 중요한가 에이전트가 실제로는 더 나은 항목이 아닌 특정 출처를 일관되게 선호하면 검색·추천·자동화 결과가 왜곡될 수 있다. 이 연구는 품질과 출처를 분리해 편향을 다루는 관점을 제시한다.
추천 대상 검색·추천·웹 에이전트의 선택 편향과 평가에 관심 있는 ML 엔지니어

LLMTrainingResearch
TL;DR. LLM 포스트트레이닝 일반화를 가르는 핵심 요인으로 on-policy 업데이트 방향 제시
- 포스트트레이닝(post-training)에서 일반화 성능 차이를 설명하는 핵심 변수로 파라미터 업데이트 방향 분석
- on-policy 방식의 파라미터 업데이트 방향이 모델의 일반화 특성과 밀접하게 연결된다는 관점 제시
- 학습 신호의 크기보다 업데이트가 향하는 방향성이 후속 성능과 전이 특성에 더 중요하다는 문제의식
왜 중요한가 LLM 포스트트레이닝 성능을 단순한 보상 최적화나 데이터 규모가 아니라 업데이트 방향 관점에서 해석하려는 연구다. 정렬·강화학습 단계에서 왜 어떤 설정은 잘 일반화하고 어떤 설정은 과적합되는지 설명하는 단서를 제공할 수 있다.
추천 대상 RLHF·정렬·포스트트레이닝 메커니즘을 이해하려는 LLM 연구자와 ML 엔지니어

AgentBenchmarkMultimodal
TL;DR. 웹 브라우징 에이전트의 다국어·멀티모달 한계 점검용 스트레스 테스트
- 웹 브라우징 에이전트 평가를 위한 HyperBrowseComp 제안, 다국어·멀티모달 조건을 함께 반영한 벤치마크 성격
- 단순 정답률보다 실제 웹 탐색 환경의 난도와 실패 양상을 드러내는 스트레스 테스트 지향
- 언어 다양성과 시각 정보 처리 요구를 포함해 기존 웹 에이전트 평가의 편향 보완 목적
왜 중요한가 웹 브라우징 에이전트 평가는 영어 중심·텍스트 중심에 치우치기 쉬운데, 이 작업은 다국어와 시각 요소를 함께 넣어 실제 사용 조건에 더 가깝게 점검한다. 모델 성능의 평균치보다 취약한 조건과 실패 지점을 드러내는 데 의미가 있다.
추천 대상 웹 에이전트 평가, 브라우저 자동화, 멀티모달 에이전트 강건성에 관심 있는 연구자·엔지니어
AI Lab Blogs · 1
LLMSecurityResearch
TL;DR. EU 텍스트 출처 규정 대응용 워터마킹·탐지 접근 정리
- OpenAI의 EU 텍스트 출처 규정 대응 방향 설명, 워터마크 적용 범위와 예외 구분
- 텍스트 워터마킹 탐지 방식 소개, 생성 텍스트의 출처 판별 가능성에 초점
- 초기 접근 대상을 연구자 중심으로 제한, 탐지 도구의 단계적 공개 접근 시사
왜 중요한가 EU의 AI 규제가 생성 텍스트 출처 표시를 요구하는 흐름에서, 실제 서비스 사업자가 워터마킹을 어디에 적용하고 어떻게 탐지할지 공개한 사례다. 규제 준수와 기술적 한계 사이의 현실적 절충안을 가늠하는 데 유용하다.
추천 대상 생성형 AI 규제 대응, 워터마킹, 텍스트 출처 검증에 관심 있는 AI 엔지니어·정책 담당자
Simon Willison's Weblog · 1
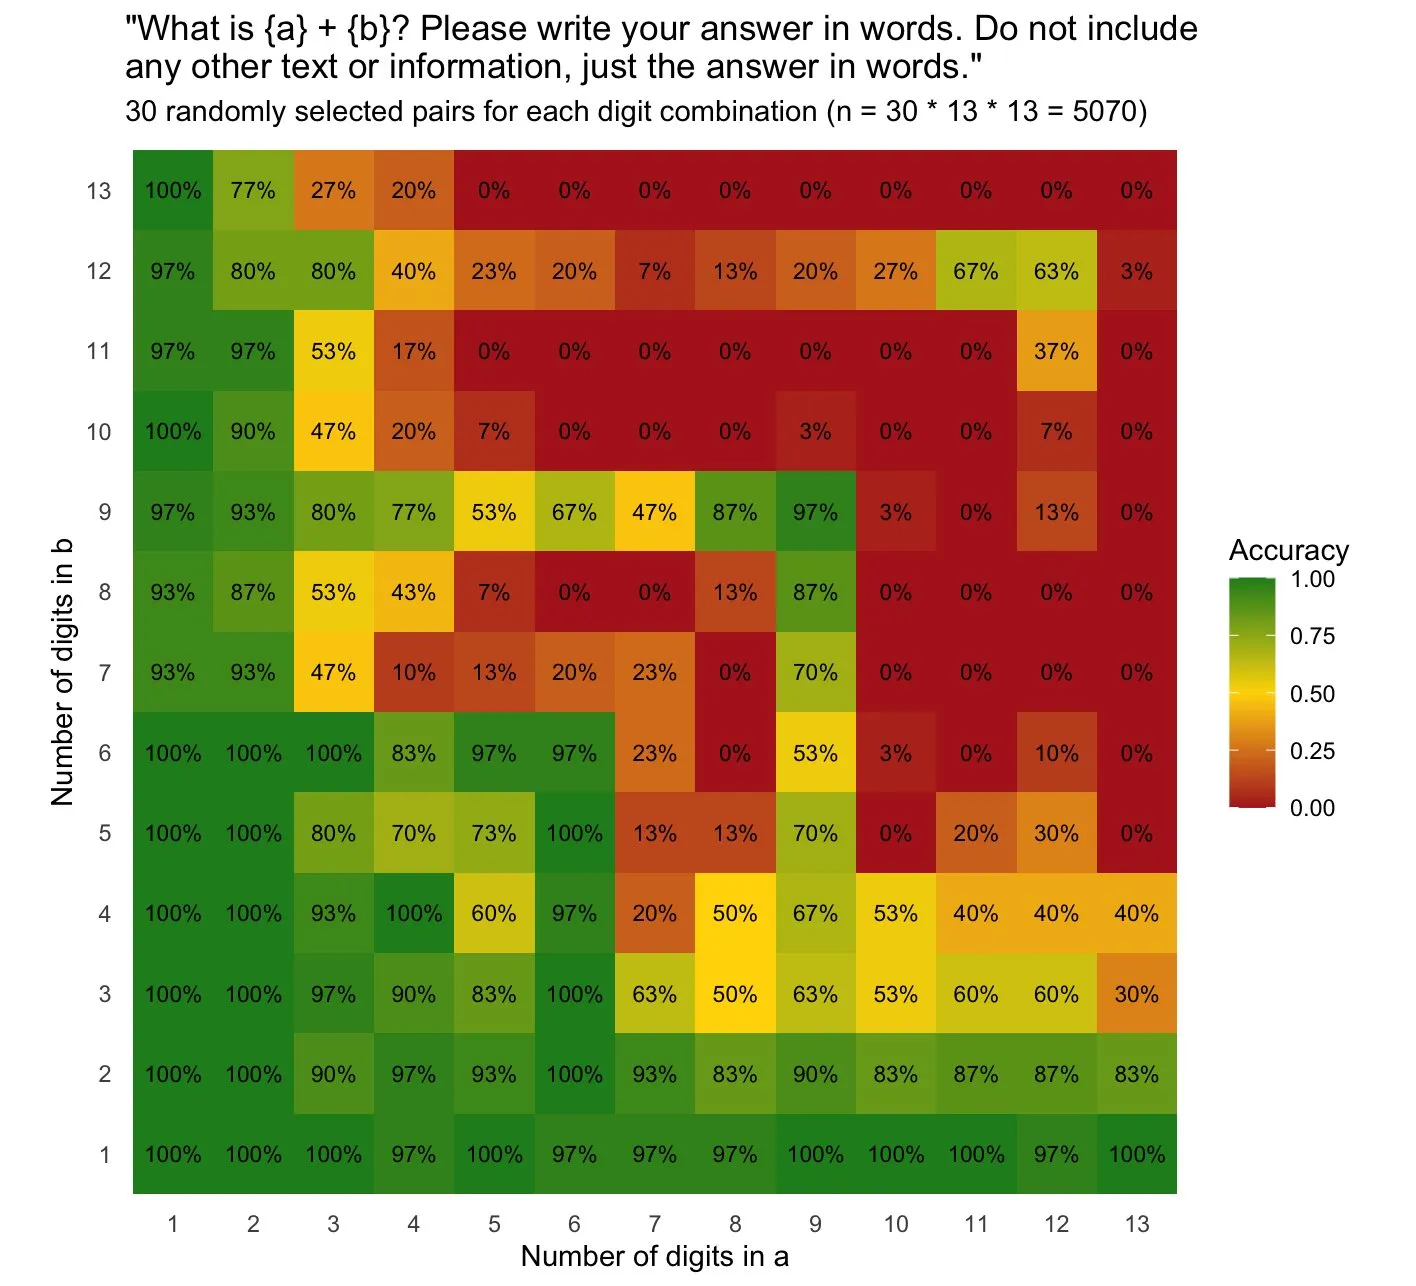
LLMReasoningResearch
TL;DR. Qwen3.8-27B의 대수 덧셈·영문 답변 능력과 추론 효과 점검
- GPT-4o의 기존 실험을 재현해, 합은 계산하되 답은 영어 단어로 출력하는 과제 평가
- DGX Spark 로컬 환경에서 Qwen3.8-27B-Q4_K_M.gguf 실행, 통제된 조건에서 성능 비교
- 추론 비활성화 시 조합당 30회 샘플링으로 히트맵 생성, 숫자 규모가 커질수록 오답 패턴 확인
왜 중요한가 산술 계산 자체보다 계산 결과를 자연어 형식으로 정확히 표현하는 능력을 분리해 점검한 사례다. 추론 활성화가 로컬 LLM의 수치 처리 정확도에 어떤 영향을 주는지, 통제된 환경에서 확인할 수 있다는 점이 의미 있다.
추천 대상 로컬 LLM 추론 성능, reasoning on/off 비교, 수리 능력 평가에 관심 있는 ML 엔지니어
r/LocalLLaMA (Top Today) · 1
LLMTrainingResearch
TL;DR. Qwen 27B 성능 체감과 GPT-4o 파라미터 규모 비교 논의
- Qwen 27B가 체감상 매우 우수한 이유를 GPT-4o의 대규모 파라미터 추정치와 대비해 묻는 토론
- 모델 성능 차이의 배경으로 고품질 사전학습 데이터와 최신 학습 기법 가능성 제기
- 파라미터 수와 실제 성능이 비례하지 않으며 데이터 품질·학습 전략이 중요하다는 문제의식
왜 중요한가 LLM 성능을 단순 파라미터 수로 설명하기 어렵다는 점을 다시 드러내는 논의다. 데이터 품질, 학습 레시피, 평가 방식이 성능 체감에 미치는 영향을 점검하는 출발점이 된다.
추천 대상 오픈 LLM 성능 비교와 학습 데이터·스케일링 법칙에 관심 있는 ML 엔지니어
Hacker News Front Page · 1
LLMReasoningTraining
TL;DR. Reflection, 501B 오픈웨이트 MoE Beam 공개 예고
- 총 501B·활성 23B sparse MoE 구조, 코딩·추론·에이전트 워크로드 중심 설계
- 23.8T 토큰 사전학습과 10.5K NVIDIA GB300 기반 4주 RL로 1억+ 롤아웃 수행
- GLM-5.2급 추론 성능에 3~4배 적은 추론 연산 주장, Qwen 3.8-Max 대비 효율성 강조
왜 중요한가 오픈웨이트 진영에서 대형 모델의 절대 성능보다 추론 효율을 전면에 내세운 사례다. 대규모 RL과 MoE를 결합해 코딩·에이전트 작업의 비용 대비 성능을 높이려는 접근이라는 점이 눈에 띈다.
추천 대상 코딩 특화 LLM, 대규모 RL 스케일링, MoE 추론 효율에 관심 있는 ML 엔지니어