| TH—NEWS |
Morning Digest — 2026-10-03
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 바로 써먹을 수 있는 실무형 글이 앞쪽에 몰려 있고, 중간중간 실험기와 연구 포스트가 섞여 있어요. 빠르게 훑는다면
A model guide for the GPT-6 family, Build Local AI Apps with C++ and NVIDIA TensorRT RTX Samples, One month coding with GLM 5.3 Flash 쪽이 특히 손에 잡히고, 나머지는 관심 분야 따라 골라 읽으면 됩니다.
🔥 꼭 볼 것
| 01 |
A model guide for the GPT-6 family
GPT-6 계열 모델 선택, 추론 전략, 툴 연동 포인트를 실무 관점으로 정리한 가이드.
💡 모델 선택과 운영 비용 판단에 바로 도움돼요.
|
| 02 |
 Build Local AI Apps with C++ and NVIDIA TensorRT RTX Samples TensorRT RTX 샘플로 로컬 추론 앱을 C++에서 빠르게 시작하는 경로를 보여줍니다.
💡 온디바이스 AI 구현 흐름을 바로 잡을 수 있어요.
|
| 03 |
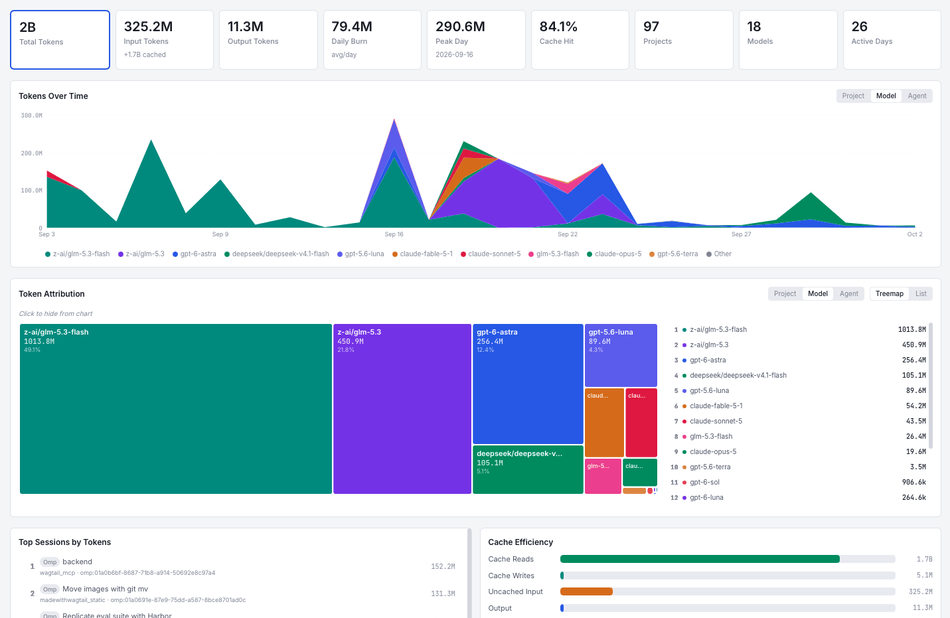 One month coding with GLM 5.3 Flash GLM 5.3 Flash를 한 달 돌려보며 드러난 비용, 인프라, 에이전트 운영 감각을 공유합니다.
💡 장기 운영 시 생기는 현실 문제를 미리 봐둘 만해요.
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | coreyhaines31/marketingskills | AI 에이전트용 마케팅 스킬셋 정리 저장소 |
| PyTorch KR | dots: 봇 탐지를 피하도록 패치하고, Firefox로 웹 작업을 하는 오픈소스 로컬 브라우저 에이전트 (≠ OpenAI … 어제 | 봇 탐지 우회를 위한 패치와 Firefox 기반 로컬 웹 에이전트 오픈소스 |
| GeekNews | 판단 전용 모델 Laya 실측 – 정확도 78%, 틀린 답에도 confidence 0.9 (파인 튜닝전에 데이터) 어제 | 오픈소스 판단 전용 모델 Laya의 중복 노트 판정 실측과 과신 문제 점검 |
| HF Papers | Multimodal Flow: Unified Flow Modeling of Language and Vision in Embe… | 언어·비전을 임베딩 공간의 단일 플로우로 통합한 멀티모달 생성 모델 |
| r/LocalLLaMA (Top Today) | I made my iPhone a second GPU for my 24 GB MacBook: Qwen 3.8 27B pref… | iPhone를 보조 GPU처럼 활용해 24GB 맥북의 Qwen 27B 프리필 가속 시도 |
Research
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| HF Papers | Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint … | 오디오-비디오 확산 생성에서 다중 보상을 동적으로 배분하는 RL 최적화 기법 |
| HF Papers | Fewer Tokens, Better Action: GPT-6 Astra Robot Agents with 14% Higher… | GPT-6 Astra 로봇 에이전트, 토큰 65% 절감과 성공률 14% 향상 동시 달성 |
📚 전체 목록 (소스별)
GitHub Trending · 1
coreyhaines31/marketingskills
JavaScript · 139 stars today · ⭐ 52,365
AgentProductivityOpenSource
TL;DR. AI 에이전트용 마케팅 스킬셋 정리 저장소
- Claude Code와 AI 에이전트를 위한 마케팅 역량 모음 저장소
- CRO, 카피라이팅, SEO, 애널리틱스, 그로스 엔지니어링 범위 포함
- GitHub 스타 5만2,365개, 하루 139개 증가로 높은 관심도 확인
왜 중요한가 코딩 중심 AI 도구에 부족한 마케팅 실행 지식을 에이전트 관점에서 구조화한 자료다. 개발뿐 아니라 전환율 최적화와 유입 분석까지 자동화 범위를 넓히려는 흐름과 맞닿아 있다.
추천 대상 AI 에이전트에 마케팅 자동화·그로스 워크플로를 붙이려는 개발자와 프로덕트 엔지니어
PyTorch KR 읽을거리 · 1
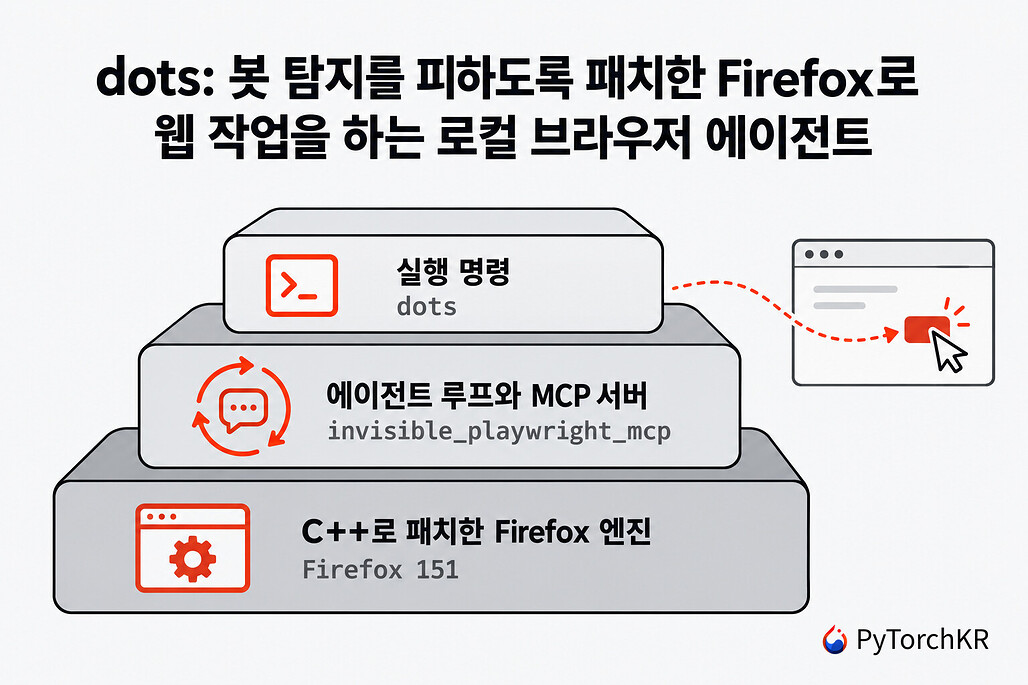
AgentBrowserOpenSource
TL;DR. 봇 탐지 우회를 위한 패치와 Firefox 기반 로컬 웹 에이전트 오픈소스
- Firefox로 웹 작업을 수행하는 로컬 브라우저 에이전트 프로젝트 소개
- 봇 탐지를 피하도록 패치한 점을 핵심 차별점으로 내세운 구성
- 오픈소스 형태로 공개된 로컬 실행형 도구로 클라우드 의존성 축소 맥락
왜 중요한가 브라우저 에이전트는 실제 웹 상호작용 자동화에서 봇 탐지에 자주 막히는데, 이를 우회하도록 설계한 점이 핵심이다. 로컬 실행형 오픈소스라는 점도 실험·검증·커스터마이징 측면에서 활용 여지를 넓힌다.
추천 대상 웹 자동화형 에이전트와 브라우저 기반 AI 워크플로에 관심 있는 개발자
GeekNews 최신 · 1
LLMInferenceResearch
TL;DR. 오픈소스 판단 전용 모델 Laya의 중복 노트 판정 실측과 과신 문제 점검
- LLM 대신 '합칠까 말까' 같은 저차원 이진 판단을 확률과 함께 반환하는 System One 모델 평가
- 개인 Obsidian 플러그인의 중복 노트 판정 작업에 Laya 적용, 파인튜닝 전 데이터 기준 정확도 78% 기록
- 오답 사례에서도 confidence 0.9 수준의 높은 확신 관측, 확률값 해석과 calibration 필요성 부각
왜 중요한가 생성형 LLM을 작은 판단 작업에 그대로 쓰지 않고, 판단 전용 모델로 분리해 비용과 구조를 단순화하려는 시도라는 점이 핵심이다. 동시에 높은 confidence가 곧 신뢰 가능한 판단을 뜻하지 않는다는 점을 실측으로 보여줘, 실서비스 적용 시 calibration과 검증 필요성을 드러낸다.
추천 대상 분류·라우팅·중복 판정 같은 소형 AI 기능을 제품에 붙이려는 개발자와 ML 엔지니어
HuggingFace Daily Papers · 3

MultimodalGenerativeResearch
TL;DR. 언어·비전을 임베딩 공간의 단일 플로우로 통합한 멀티모달 생성 모델
- 언어와 비전을 각각 분리하지 않고 임베딩 공간에서 unified flow modeling 제안
- 토큰 기반 이산 생성과 픽셀·latent 기반 연속 생성을 하나의 플로우 프레임워크로 정렬
- 멀티모달 표현 학습과 생성 과정을 단일 모델링 관점으로 다루는 연구 방향 제시
왜 중요한가 기존에는 언어와 비전이 서로 다른 표현·생성 방식으로 별도 모델링되는 경우가 많았다. 이 연구는 두 모달리티를 임베딩 공간의 단일 플로우로 다뤄, 멀티모달 생성 모델의 공통 기반을 만들려는 시도라는 점에서 의미가 있다.
추천 대상 멀티모달 생성 모델, unified architecture, 플로우 기반 생성 연구를 보는 ML 엔지니어

Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL
arXiv
AudioVideoDiffusion
TL;DR. 오디오-비디오 확산 생성에서 다중 보상을 동적으로 배분하는 RL 최적화 기법
- 공동 오디오-비디오 diffusion 생성에서 여러 reward를 상황별로 동적으로 라우팅하는 Adaptive Reward Routing 제안
- forward-process RL 기반 최적화로 생성 과정 중 reward 적용 경로를 조정하는 접근
- 단일 보상 또는 고정 결합 방식 대비 다중 목적 최적화 유연성 강화에 초점
왜 중요한가 오디오-비디오 공동 생성은 품질, 동기화, 정합성 등 서로 다른 목표를 동시에 맞춰야 해 보상 설계가 까다롭다. 이 연구는 보상을 고정 가중합으로 묶지 않고 생성 과정에서 동적으로 배분해 다목적 최적화의 제어 가능성을 넓히려는 점이 핵심이다.
추천 대상 멀티모달 생성, diffusion 모델 RL 튜닝, 오디오-비디오 정합성 개선에 관심 있는 연구자와 ML 엔지니어

Fewer Tokens, Better Action: GPT-6 Astra Robot Agents with 14% Higher Success Rate but 65% Fewer Tokens
arXiv
RoboticsAgentLLM
TL;DR. GPT-6 Astra 로봇 에이전트, 토큰 65% 절감과 성공률 14% 향상 동시 달성
- GPT-6 Astra 기반 로봇 에이전트가 기존 대비 성공률 14% 높은 성능 보고
- 행동 생성 과정의 토큰 사용량 65% 감소로 추론 효율과 비용 측면 개선
- 적은 토큰으로 더 나은 액션을 유도하는 로봇 제어·에이전트 설계 방향 제시
왜 중요한가 로봇 에이전트는 긴 컨텍스트와 반복 추론으로 토큰 비용과 지연이 커지기 쉽다. 이 결과는 토큰을 크게 줄이면서도 실제 작업 성공률을 높여, LLM 기반 로봇 제어의 실용성을 끌어올린다는 점에서 의미가 있다.
추천 대상 LLM 기반 로봇 제어와 에이전트 추론 효율화에 관심 있는 ML 엔지니어
AI Lab Blogs · 2
LLMReasoningTooling
TL;DR. 스타트업 관점의 GPT-6 계열 선택·추론·툴 연동 실무 가이드
- OpenAI의 GPT-6 계열 모델 선택 기준과 스타트업용 적용 전략 정리
- 추론 강도(reasoning effort) 조절을 통한 성능·지연·비용 균형화 방법 소개
- 프롬프트 개선과 스킬(skills) 활용으로 작업 품질을 높이는 실무 팁 제공
왜 중요한가 모델 성능 자체보다 어떤 GPT-6 변형을 고르고 추론 강도와 툴 사용을 어떻게 조합할지에 초점을 둔 점이 핵심이다. LLM 도입 팀이 PoC를 넘겨 실제 운영 워크플로로 연결할 때 필요한 의사결정 기준을 정리한다.
추천 대상 GPT 기반 제품 설계·서빙·에이전트 워크플로 운영을 준비하는 개발자와 AI 엔지니어
InferenceToolingInfra
TL;DR. C++용 TensorRT RTX 샘플로 로컬 AI 앱 구현 경로 제시
- 로컬 애플리케이션에 AI 모델을 붙이기 위한 핵심 요소로 이식 가능한 모델 포맷, 안정적 런타임, 시스템 전반 가속 제시
- NVIDIA TensorRT RTX 샘플을 활용한 C++ 기반 로컬 AI 앱 개발 흐름 소개
- 클라우드 의존 대신 대상 시스템에서 직접 추론(inference)하는 로컬 실행 시나리오 초점
왜 중요한가 로컬 AI 앱은 모델 포맷, 런타임, 하드웨어 가속이 함께 맞물려야 실제 배포가 가능하다. 이 글은 C++ 개발자가 TensorRT RTX 샘플을 바탕으로 온디바이스 추론 경로를 빠르게 이해하는 데 도움을 준다.
추천 대상 C++ 기반 온디바이스 AI 추론과 NVIDIA 런타임 활용에 관심 있는 개발자
r/LocalLLaMA (Top Today) · 1
LLMInferenceInfra
TL;DR. iPhone를 보조 GPU처럼 활용해 24GB 맥북의 Qwen 27B 프리필 가속 시도
- 24GB M4 Pro MacBook에서 Qwen 3.8 27B(IQ4_XS) 구동 시 iPhone 17 Pro Max를 추가 연산 자원으로 활용한 구성
- Qwen 3.8 27B 프리필(prefill) 속도 29~44% 향상 주장, 다만 휴대폰 표시 TPS는 보유 레이어 기준이라 별도 주의 필요
- 기존에는 8비트 기준 64k 컨텍스트만 적재 가능했고, 모델과 함께 CTX window 일부를 휴대폰으로 분산하는 접근
왜 중요한가 단일 노트북 메모리 제약으로 대형 로컬 LLM의 컨텍스트와 프리필 속도가 병목이 되는 문제를, 보유 중인 모바일 기기를 보조 연산 자원으로 활용해 완화하려는 사례다. 추가 GPU 없이 개인 장비만으로 추론 성능을 끌어올릴 수 있다는 점이 눈에 띈다.
추천 대상 로컬 LLM 추론 최적화와 개인 장비 기반 분산 실행에 관심 있는 ML 엔지니어
Hacker News Front Page · 1
LLMAgentInference
TL;DR. GLM 5.3 Flash 한 달 실험에서 드러난 비용·인프라·에이전트 운영 교훈
- 월간 목표 모델은 GLM 5.3 Flash였지만 실제 사용은 2B 토큰 중 1B 토큰, 약 50% 비중
- 초반 절반은 예산 내 운영 성공, 비용 68달러·에너지 4kWh·탄소배출 365g 수준
- 프로토타입 MCP 서버에서 모델 선택 오류로 450M 토큰·150달러·5kWh를 단기간 소모
왜 중요한가 저비용 flash급 모델로 일상 개발 업무를 처리할 수 있는지 실제 운영 수치로 점검한 사례다. 모델 선택 실수, 인프라 수급, 에이전트 패턴이 총비용과 에너지 사용량에 큰 영향을 준다는 점을 보여준다.
추천 대상 LLM 사용량 관리, 추론 비용 최적화, 에이전트 개발 워크플로에 관심 있는 엔지니어