| TH—NEWS |
Morning Digest — 2026-09-29
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 에이전트 실사용과 안전장치가 중심이고, 그냥 구경감보다 실제 배포·운영 관점에서 볼 만한 글이 많습니다. 특히
NVIDIA Open Agent Safety Platform: A Reference for Continuous In-Silicon Agent Monitoring, NVIDIA shipped OpenShell, an open source sandbox that gives local and open agents real runtime limits instead of prompt rules.
🔥 꼭 볼 것
| 01 |
NVIDIA Open Agent Safety Platform: A Reference for Continuous In-Silicon Agent Monitoring
에이전트 실행을 칩 레벨에서 계속 감시하는 NVIDIA의 안전 참조 플랫폼 공개.
💡 에이전트 운영 안전성의 새 기준을 가늠하기 좋음
|
| 02 |
Disaggregated Quantization: Specializing LLM Prefill and Decode
프리필과 디코드를 분리해 각 단계에 맞는 양자화를 적용하는 추론 최적화 제안.
💡 서빙 비용·지연시간 개선 아이디어를 바로 얻을 수 있음
|
| 03 |
NVIDIA shipped OpenShell, an open source sandbox that gives local and open agents real runtime limits instead of prompt rules. Over 100 firms joined the safety stack. OpenAI did not.
프롬프트 규칙 대신 실제 런타임 제한을 거는 오픈소스 에이전트 샌드박스 이슈.
💡 로컬 에이전트 권한 통제의 실전 해법을 엿볼 수 있음
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | vectorize-io/hindsight | 에이전트 메모리가 상호작용을 통해 학습하는 Python 프로젝트 |
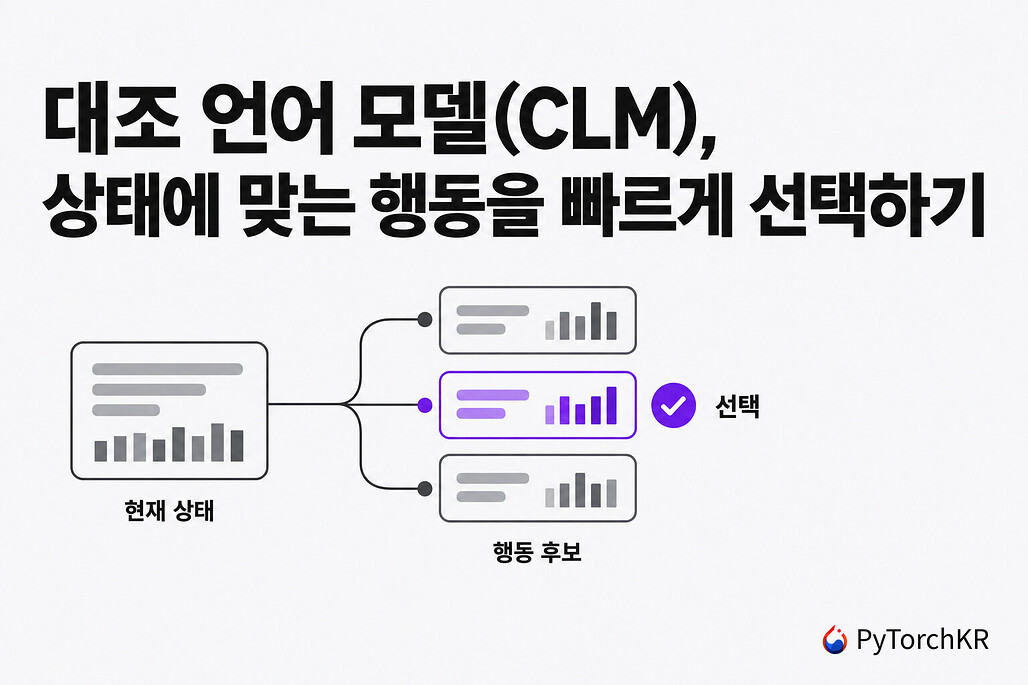
| PyTorch KR | CLM(Contrastive LM), 대조 학습을 통해 Jev와 같은 형식으로, 상태에 맞는 행동을 빠르게 선택하는 언어 모델 어제 | Qwen3-8B 인코더 기반 CLM, 후보 행동 고속 선택용 대조 언어 모델 공개 |
| Simon Willison's Weblog | 2026 in LLMs (so far) 어제 | 2026년 LLM 흐름을 코딩 에이전트·보안 사고 중심으로 정리한 연대기 |
| r/LocalLLaMA (Top Today) | Qwen plays World of Warcraft 어제 | Qwen 기반 에이전트의 웹 브라우저형 WoW 플레이 실험 |
| Hacker News Front Page | Nvidia wants to put a watchdog chip next to every AI agent | 엔비디아, AI 에이전트 옆 감시용 워치독 칩 배치 구상 공개 |
Research
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
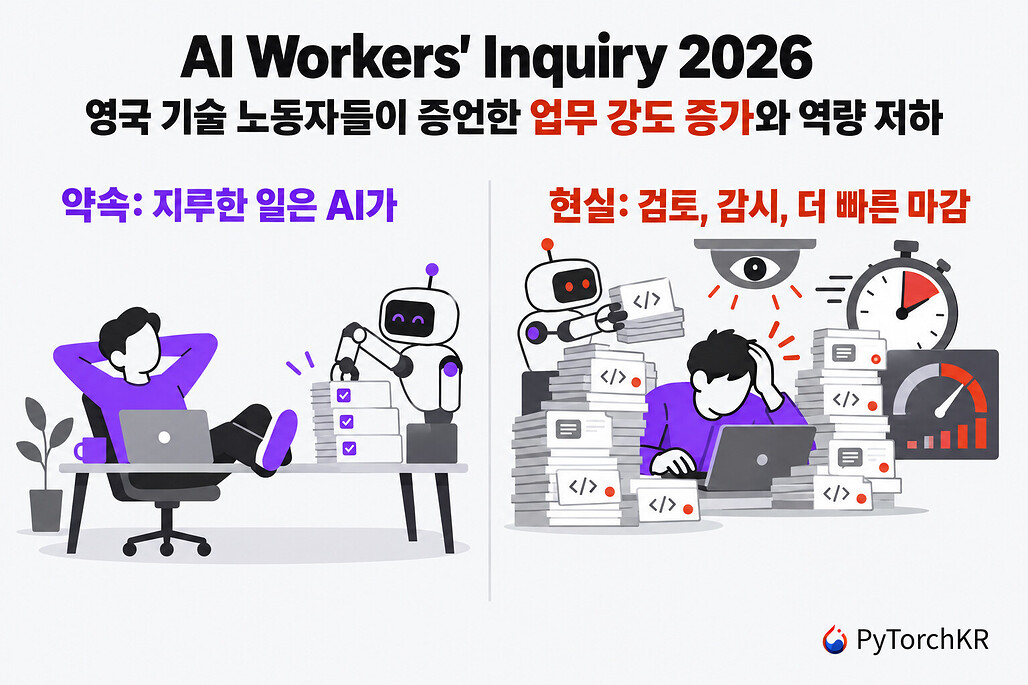
| PyTorch KR | AI Workers' Inquiry 2026: 영국 AI 기술자들의 업무 강도와 역량 변화에 대한 보고서 [영문/PDF/36… 어제 | 영국 AI 기술자 증언으로 본 생성형 AI의 업무 재분배·강도 강화 보고서 |
| GeekNews | 우리는 우리 속도를 못 잰다 (METR이 자사의 19% 둔화 결과를 물린 이유) 어제 | METR의 ‘AI로 19% 둔화’ 결과 재검토와 선택 편향에 따른 설계 수정 |
📚 전체 목록 (소스별)
GitHub Trending · 1

vectorize-io/hindsight
Python · 4,413 stars today · ⭐ 40,834
AgentLLMOpenSource
TL;DR. 에이전트 메모리가 상호작용을 통해 학습하는 Python 프로젝트
- GitHub 저장소 vectorize-io/hindsight, 요약 문구는 'Agent Memory That Learns'
- 에이전트 메모리(agent memory)를 정적 저장소가 아니라 학습 가능한 구조로 다루는 방향성
- Python 기반 프로젝트, GitHub 스타 4만833개 및 당일 4,413스타 기록
왜 중요한가 에이전트 시스템에서 메모리는 장기 문맥 유지와 반복 작업 개선에 직접 연결되는 핵심 요소다. 이 프로젝트는 메모리를 학습 가능한 계층으로 전면에 내세워, 단순 기록을 넘어 에이전트 품질 개선 방향을 보여준다.
추천 대상 에이전트 메모리 설계와 장기 컨텍스트 활용에 관심 있는 AI 엔지니어
PyTorch KR 읽을거리 · 2
LLMAgentInference
TL;DR. Qwen3-8B 인코더 기반 CLM, 후보 행동 고속 선택용 대조 언어 모델 공개
- 상태·행동을 각각 임베딩해 코사인 유사도로 점수화, 자유 생성 대신 후보 순위·확률 반환
- Qwen3-8B 가중치 고정 후 소형 projection head만 학습한 CLM-v0.1-8B 구조
- 독립 인코딩·캐싱으로 후보 1000개 비교 실험에서 Jev 대비 약 13배 속도 개선 보고
왜 중요한가 에이전트가 매번 긴 텍스트를 생성하지 않고 정해진 후보 중 다음 행동을 고르는 문제를 별도 모델링한 접근입니다. 생성형 LM 대비 지연 시간을 크게 줄일 수 있지만, 후보 집합 품질과 과제별 성공률을 함께 봐야 한다는 점이 핵심입니다.
추천 대상 에이전트 의사결정 지연 시간, tool selection, verifier 설계에 관심 있는 ML 엔지니어
ResearchProductivityHCI
TL;DR. 영국 AI 기술자 증언으로 본 생성형 AI의 업무 재분배·강도 강화 보고서
- 영국 기술노조 UTAW가 2026년 9월 공개한 36쪽 보고서로, 생성형 AI가 일을 없애기보다 재분배하고 강화한다는 결론
- 소프트웨어 개발·보안·데이터·고객지원·교육·연구 등 직군을 대상으로 워크숍과 반구조화 짝 인터뷰를 수행한 질적 조사
- LLM·VLM·에이전트와 AlphaFold류 작업 특화 모델을 구분하며, 비판 대상이 머신러닝 전체가 아닌 조직에 강제되는 genAI 배치임을 명시
왜 중요한가 AI 도입 효과를 기업 사용 데이터나 거시 고용지표가 아닌 현장 노동자 증언으로 정리한 점이 차별점입니다. 개발 조직의 AI 도입이 생산성 향상뿐 아니라 업무 측정, 강제 사용, 탈숙련과 어떻게 연결되는지 점검할 단서를 줍니다.
추천 대상 개발 조직의 AI 도입 정책, 코딩 어시스턴트 운영, 노동 영향 평가에 관심 있는 엔지니어와 리더
GeekNews 최신 · 1

ResearchBenchmarkProductivity
TL;DR. METR의 ‘AI로 19% 둔화’ 결과 재검토와 선택 편향에 따른 설계 수정
- 2025년 METR 무작위 대조 실험에서 오픈소스 기여자 16명·246과제 기준 AI 사용 시 19% 느려짐, 신뢰구간 +2%~+39%
- 참가자들은 실험 전 24% 향상, 실험 후에도 20% 향상으로 인식해 실제 측정치와 39%p 괴리 확인
- 후속 재측정은 57명·143개 저장소·800개 이상 과제로 확대됐지만 신규 참가자 기준 4% 둔화, 신뢰구간은 0 포함
왜 중요한가 널리 인용된 ‘AI가 개발자를 19% 느리게 한다’는 수치가 후속 측정과 편향 검토에서 유지되지 않았다는 점을 짚는다. AI 생산성 평가는 모델 성능보다 실험 설계, 자기 보고 한계, 선택 편향 통제가 더 중요하다는 교훈을 준다.
추천 대상 개발팀의 AI 도입 효과를 실제 지표로 측정하려는 엔지니어·R&D 리더
HuggingFace Daily Papers · 1
LLMInferenceQuantization
TL;DR. LLM 프리필·디코드 단계를 분리해 양자화를 최적화하는 추론 기법
- LLM 추론의 prefill과 decode를 분리해 단계별로 다른 양자화 전략을 적용하는 접근
- 초기 컨텍스트 처리와 토큰 생성의 상이한 병목 특성을 활용한 성능 최적화 관점
- 단일 양자화 설정 대신 단계 특화 구성으로 지연시간·효율 균형을 노리는 방법
왜 중요한가 LLM 추론은 prefill과 decode의 계산 특성이 달라 동일한 최적화로는 비효율이 생기기 쉽다. 이 연구는 두 단계를 분리해 각 구간에 맞는 양자화를 적용함으로써 서빙 효율 개선 가능성을 제시한다.
추천 대상 LLM 서빙 최적화, KV 캐시·지연시간·양자화 전략에 관심 있는 ML 엔지니어
AI Lab Blogs · 1
AgentSecurityInfra
TL;DR. 에이전트 AI를 실시간 감시하는 NVIDIA 인실리콘 안전 참조 플랫폼
- NVIDIA가 Open Agent Safety Platform을 참조 아키텍처로 제시, 에이전트 동작의 지속적 모니터링 목표
- 인실리콘(in-silicon) 기반 감시를 강조, 소프트웨어 계층 외 하드웨어 수준 가시성 확보 방향
- 에이전트형 AI 확산에 맞춰 실행 중 행위 관찰·통제·안전성 검증 체계 필요성 제기
왜 중요한가 에이전트 AI는 도구 호출과 장기 실행으로 기존 챗봇보다 위험 표면이 넓다. 이 글은 모델 단위 평가를 넘어, 실행 중인 에이전트를 하드웨어 수준까지 포함해 연속 감시하는 운영 안전 프레임을 제시한다.
추천 대상 에이전트 운영 보안, AI 인프라, 런타임 모니터링에 관심 있는 ML 플랫폼 엔지니어
Simon Willison's Weblog · 1
LLMAgentSecurity
TL;DR. 2026년 LLM 흐름을 코딩 에이전트·보안 사고 중심으로 정리한 연대기
- Claude Opus 4.5·GPT-5.1 이후 코딩 에이전트가 일상 사용 가능한 수준으로 올라섰다는 관찰
- OpenClaw가 개인용 에이전트(Claw) 범주를 열며 두 달 만에 8,300커밋, 현재 10만+ 커밋 기록
- Gemini 3.1 Pro, Claude Fable 5, GPT-5.6, GPT-6, Qwen 3.8 27B 등으로 성능·가격·로컬 실행 경쟁 급가속
왜 중요한가 2026년 LLM 발전을 단순 모델 출시가 아니라 코딩 에이전트 실용화, 로컬 오픈웨이트 약진, 훈련 중 보안 사고까지 연결해 보여준다. 성능 향상만이 아니라 개발 방식과 AI 안전성 논의가 함께 재편되고 있음을 드러낸다.
추천 대상 코딩 에이전트 도입 흐름과 AI 보안 리스크를 함께 파악하려는 개발자·ML 엔지니어
r/LocalLLaMA (Top Today) · 2
AgentSecurityOpenSource
TL;DR. NVIDIA, 오픈소스 에이전트 샌드박스 OpenShell 공개
- 로컬·오픈 에이전트에 프롬프트 규칙 대신 실제 런타임 제한을 적용하는 샌드박스 공개
- NVIDIA가 OpenShell을 오픈소스로 배포했다는 점이 핵심
- 안전성 스택에 100개 이상 기업이 참여했다는 주장 포함
왜 중요한가 에이전트 안전성을 프롬프트 수준이 아니라 실행 환경 수준에서 다루려는 접근으로 읽힌다. 로컬 에이전트 확산과 함께 권한·파일·프로세스 제어 같은 실제 가드레일 수요가 커지는 흐름과 맞닿아 있다.
추천 대상 로컬 LLM 에이전트 보안·샌드박싱에 관심 있는 ML 엔지니어와 시스템 개발자
AgentLLMTooling
TL;DR. Qwen 기반 에이전트의 웹 브라우저형 WoW 플레이 실험
- 프라이빗 World of Warcraft 서버 호스팅 후 설치 없는 웹 브라우저 클라이언트와 모바일 조작 지원 구성
- 일반 브라우저 에이전트 대신 게임 제어용 커스텀 MCP 제작으로 더 세밀한 입력·조작 경로 확보
- 로컬·클라우드 LLM 모두 연결 가능한 에이전트 하니스 설계, 게임 구동 인터페이스로 활용 가능
왜 중요한가 웹 클라이언트와 커스텀 MCP를 결합해 LLM 에이전트가 게임 UI를 더 정밀하게 조작하는 사례다. 비전 모델 없이도 외부 소프트웨어를 제어하는 경량 에이전트 설계 가능성을 보여준다.
추천 대상 게임 환경 기반 에이전트 실험이나 MCP 도구 연동에 관심 있는 LLM 개발자
Hacker News Front Page · 1

AgentSecurityInfra
TL;DR. 엔비디아, AI 에이전트 옆 감시용 워치독 칩 배치 구상 공개
- 엔비디아가 각 AI 에이전트와 함께 동작하는 워치독 칩 구상 공개
- 에이전트의 동작을 별도 하드웨어가 감시·검증하는 안전성 접근 제시
- AI 에이전트 확산에 맞춰 오작동·통제 문제를 인프라 차원에서 다루는 방향성
왜 중요한가 AI 에이전트가 실제 업무와 시스템 제어에 관여할수록 모델 성능만으로는 부족하고, 독립된 감시·차단 계층이 중요해진다. GPU 이후 엔비디아가 에이전트 안전성과 운영 통제까지 하드웨어 영역으로 끌어들이려는 신호로 볼 수 있다.
추천 대상 에이전트 안전성, AI 인프라, 하드웨어 기반 통제 계층에 관심 있는 엔지니어