| TH—NEWS |
Morning Digest — 2026-09-24
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 모델 가격 경쟁과 에이전트 실행 환경이 같이 달아오른 날이에요. 바로 실무 감각으로 읽을 만한 건
Claude Opus 5.5, GPT-6 Sol, GPT-6 Luna, and a new price war, Strands Harness, How SWE-Serve Exposes the Gap Between Local Tests and Live Serving 쪽이고, 나머지는 새 도구나 연구를 가볍게 훑어도 흐름 파악엔 충분합니다.
🔥 꼭 볼 것
| 01 |
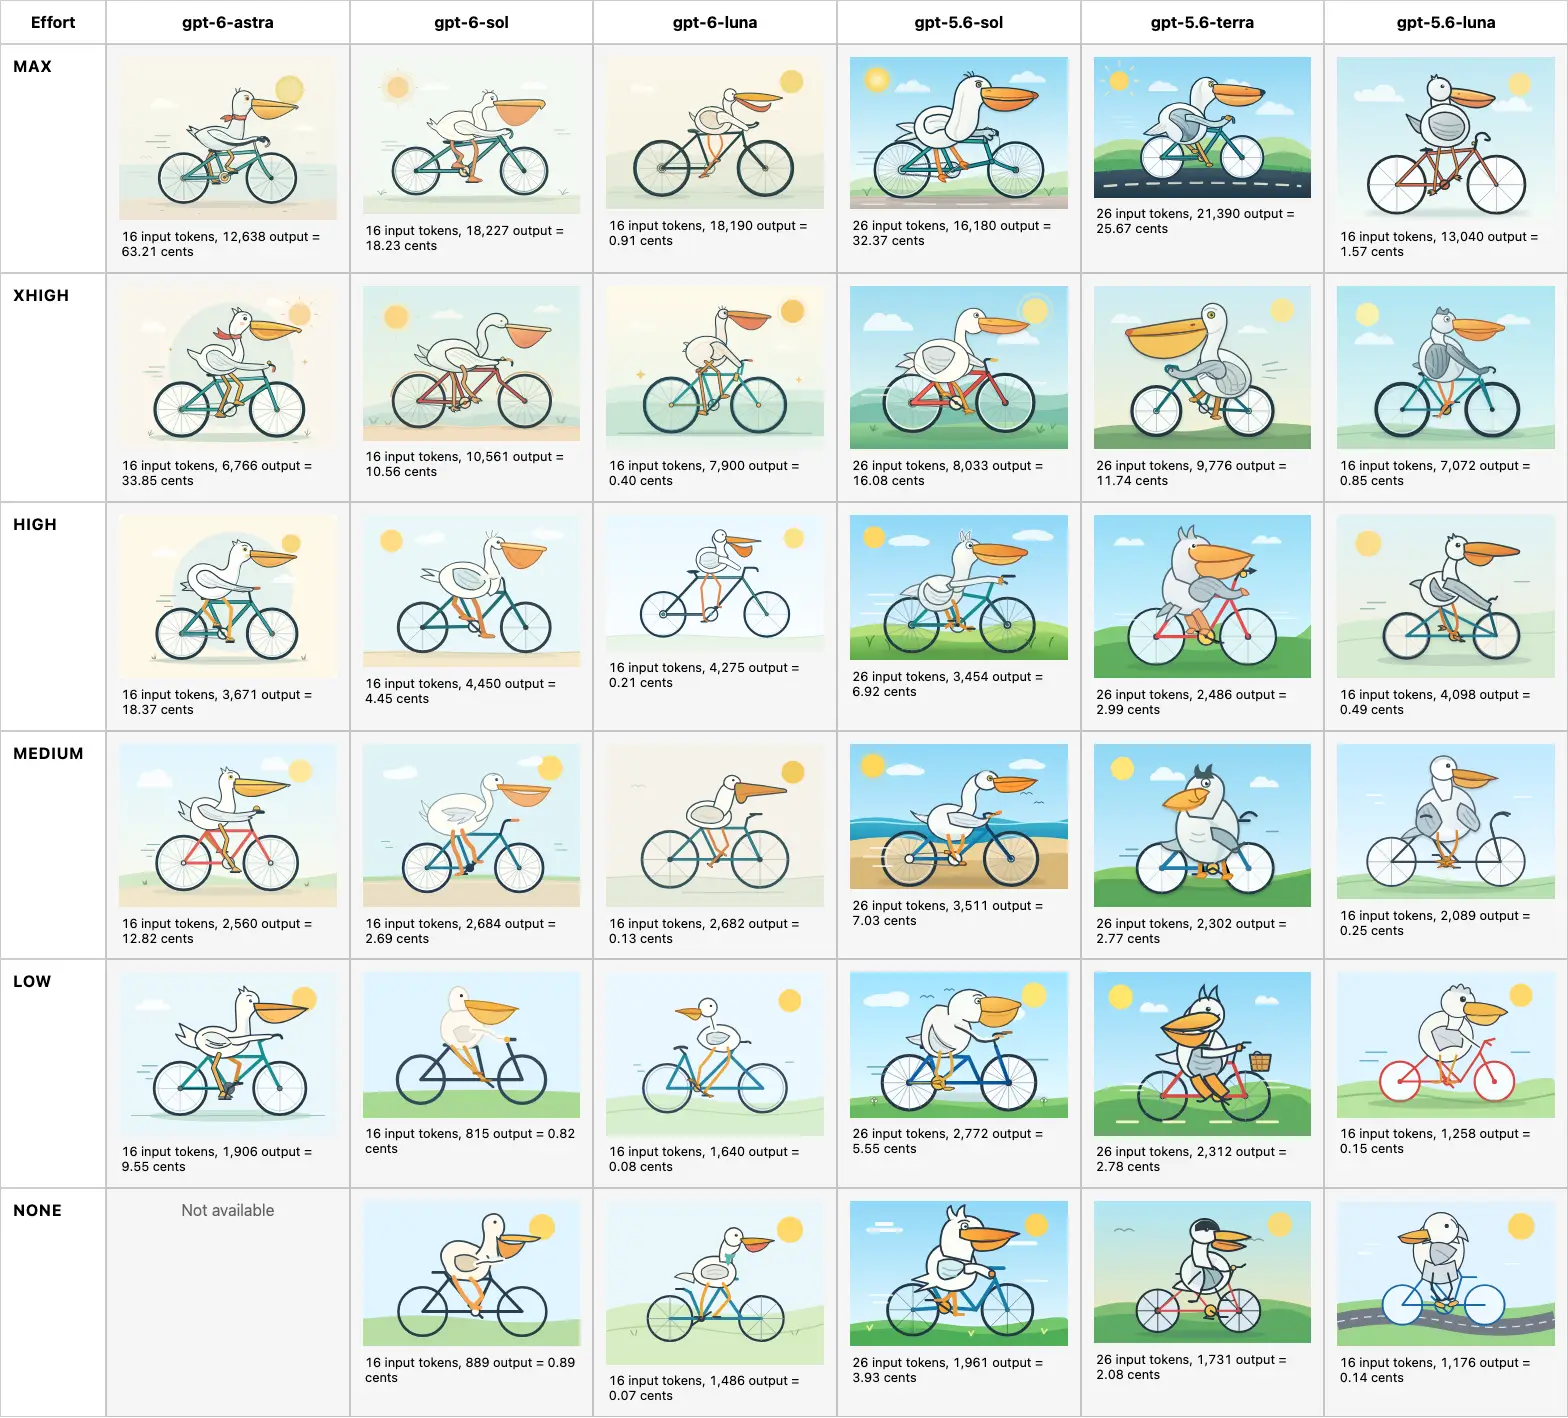 Claude Opus 5.5, GPT-6 Sol, GPT-6 Luna, and a new price war 최신 고성능 모델 공개와 함께 API 가격 경쟁이 본격화된 흐름 정리.
💡 모델 선택과 비용 계획에 직접 영향 줍니다.
|
| 02 | |
| 03 |
 How SWE-Serve Exposes the Gap Between Local Tests and Live Serving 로컬에선 통과하지만 실제 서빙에선 깨지는 에이전트 평가 공백을 짚습니다.
💡 배포 전 검증 체계를 다시 보게 만드는 글입니다.
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| PyTorch KR | StepFun Step 5 Preview 출시: Kimi K3와 같은 지능, 작업 비용은 1/3, 가중치 공개는 10/15 … 어제 | Step 5 Preview, Kimi K3급 지능에 비용 3분의 1인 MoE 에이전트 모델 |
| GeekNews | Fluree DB - 이력과 검증, 브랜치 병합을 갖춘 그래프 데이터베이스 어제 | 이력·검증·브랜치 병합을 갖춘 Rust 기반 그래프 DB |
| HF Papers | Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memor… | 확산 LLM용 IO 최적화 KV 캐시와 병렬 디코딩으로 지연·메모리 절감 |
| r/LocalLLaMA (Top Today) | Jev isn't new tech. Its marketing targets people who think AI started… | Jev의 신기술 주장에 대한 반론, 기존 분류기·제로샷 기법의 재포장 지적 |
| Hacker News Front Page | Tokens too cheap to meter 어제 | 토큰 비용 급락과 효율 개선으로 LLM의 인프라화 전망 정리 |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | davila7/claude-code-templates | Claude Code 설정·모니터링용 Python CLI 템플릿 모음 |
Research
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| Simon Willison's Weblog | Gemini 3.8 TTS Playground | Gemini 3.8 TTS 신모델과 브라우저 기반 멀티보이스 플레이그라운드 소개 |
📚 전체 목록 (소스별)
GitHub Trending · 1

davila7/claude-code-templates
Python · 393 stars today · ⭐ 31,455
ToolingProductivityOpenSource
TL;DR. Claude Code 설정·모니터링용 Python CLI 템플릿 모음
- Claude Code 구성과 모니터링을 위한 CLI 도구 템플릿 제공
- GitHub Trending 기준 Python 프로젝트, 스타 3만1,455개 기록
- 하루 기준 393개 스타 증가로 개발자 관심도 확인
왜 중요한가 Claude Code를 사용할 때 반복되는 설정과 운영 확인 작업을 CLI 형태로 정리한 템플릿 저장소다. 개별 스크립트를 매번 직접 구성하는 대신 재사용 가능한 기반을 제공한다.
추천 대상 Claude Code 워크플로 자동화와 운영 편의성 향상에 관심 있는 개발자
PyTorch KR 읽을거리 · 1
LLMAgentOpenSource
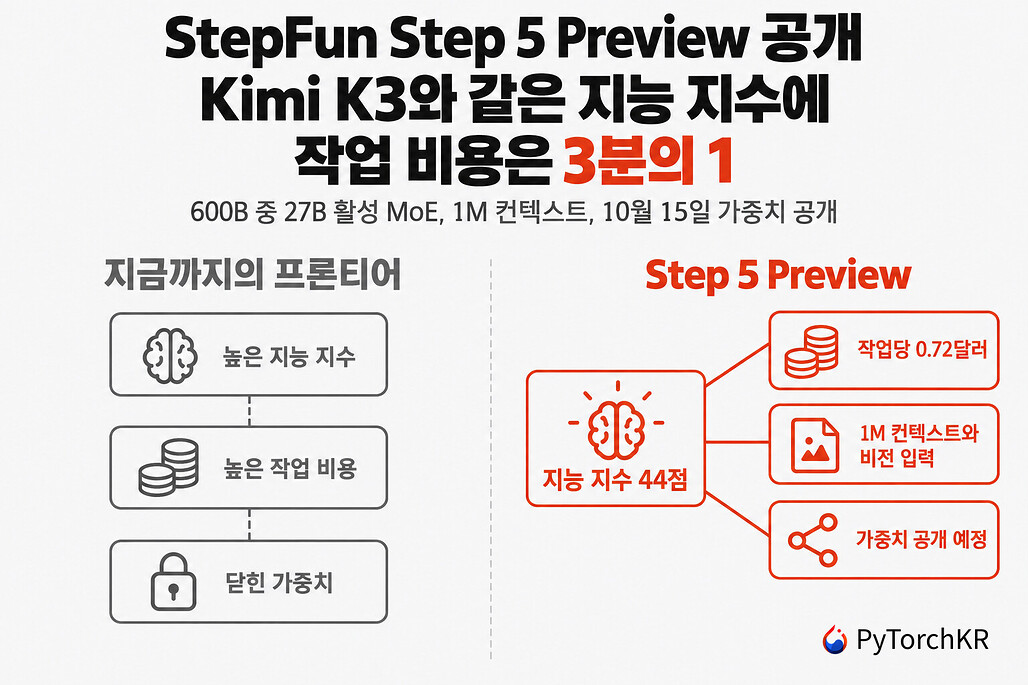
TL;DR. Step 5 Preview, Kimi K3급 지능에 비용 3분의 1인 MoE 에이전트 모델
- 600B MoE 구조에서 토큰당 27B 활성화, 1M 컨텍스트와 이미지·영상 입력 지원
- Artificial Analysis 지능 지수 44로 Kimi K3와 동점, 작업당 비용은 0.72달러로 약 64% 절감
- API 가격은 입력 100만 토큰당 1.00달러, 캐시 적중 0.05달러, 출력 2.70달러 공개
왜 중요한가 고성능 모델 비교를 벤치마크 1위보다 비용 대비 지능으로 가져간 점이 핵심입니다. 긴 시간 범위의 코딩·사후학습 루프 실험까지 제시해 에이전트형 작업에서의 실용성을 함께 검증하려는 흐름도 보입니다.
추천 대상 에이전트형 LLM 도입 비용과 오픈 웨이트 대안을 함께 보는 ML 엔지니어
GeekNews 최신 · 1
DatabaseGraphAgent
TL;DR. 이력·검증·브랜치 병합을 갖춘 Rust 기반 그래프 DB
- 시간축 질의(time travel), 검증 가능 데이터, Git 유사 브랜치·병합 지원 그래프 DB
- RDF 1.1/1.2, SPARQL, JSON-LD, openCypher를 단일 엔진으로 처리, 동일 기능·성능 제공
- 21.5B Wikidata에서 WGPB 850개 질의 기하평균 43ms, 8.19B truthy 기준 차선 대비 10.4배 빠름
왜 중요한가 그래프 DB가 보통 포기하던 이력 추적, 검증성, 정책 제어를 성능 저하 없이 함께 가져가려는 접근이다. AI 에이전트용 장기 메모리와 문서 인제스트까지 묶어 데이터 저장소와 활용 계층을 동시에 겨냥한다.
추천 대상 그래프 DB, 지식그래프, AI 에이전트 메모리 저장소를 검토 중인 백엔드·ML 엔지니어
HuggingFace Daily Papers · 1

Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
arXiv
LLMInferenceResearch
TL;DR. 확산 LLM용 IO 최적화 KV 캐시와 병렬 디코딩으로 지연·메모리 절감
- Flash-dLLM 제안, diffusion LLM 추론에서 KV 캐싱 병목을 IO 관점으로 최적화한 구조
- 병렬 디코딩(parallel decoding) 결합으로 생성 속도 향상과 메모리 효율 개선 동시 추구
- 자기회귀 LLM 중심 최적화와 달리 diffusion LLM의 반복 추론 패턴에 맞춘 캐시 설계
왜 중요한가 확산 LLM은 반복적인 디노이징 과정으로 추론 비용과 KV 메모리 부담이 커지기 쉽다. 이 연구는 모델 구조 자체보다 시스템 계층의 IO 병목과 캐시 방식을 겨냥해 실제 서빙 효율을 높이려는 접근이라는 점이 중요하다.
추천 대상 LLM 추론 최적화, KV cache 설계, diffusion LLM 서빙에 관심 있는 ML 시스템 엔지니어
AI Lab Blogs · 1
LLMInferenceBenchmark
TL;DR. 로컬 테스트 통과와 실제 추론 서빙 실패 간 간극을 드러내는 SWE-Serve
- AI 코딩 에이전트 패치가 테스트는 통과해도 실제 모델 로드·요청 처리 단계에서 실패하는 문제 조명
- 추론 서빙 소프트웨어 평가는 단위 테스트뿐 아니라 라이브 서빙 환경 검증이 필요하다는 점 제시
- SWE-Serve를 통해 로컬 개발 환경과 운영 서빙 환경 간 불일치가 에이전트 평가를 왜곡할 수 있음을 노출
왜 중요한가 코드 생성·수정 에이전트 평가는 테스트 통과율만으로는 운영 품질을 보장하지 못한다. 실제 추론 서빙처럼 상태ful 런타임과 모델 로딩이 개입하는 영역에서는 라이브 환경 기반 평가가 더 중요하다는 점을 짚는다.
추천 대상 LLM 추론 서버, AI 에이전트 평가, 배포 전 검증 체계에 관심 있는 ML/서빙 엔지니어
Simon Willison's Weblog · 2
AudioSpeechTooling
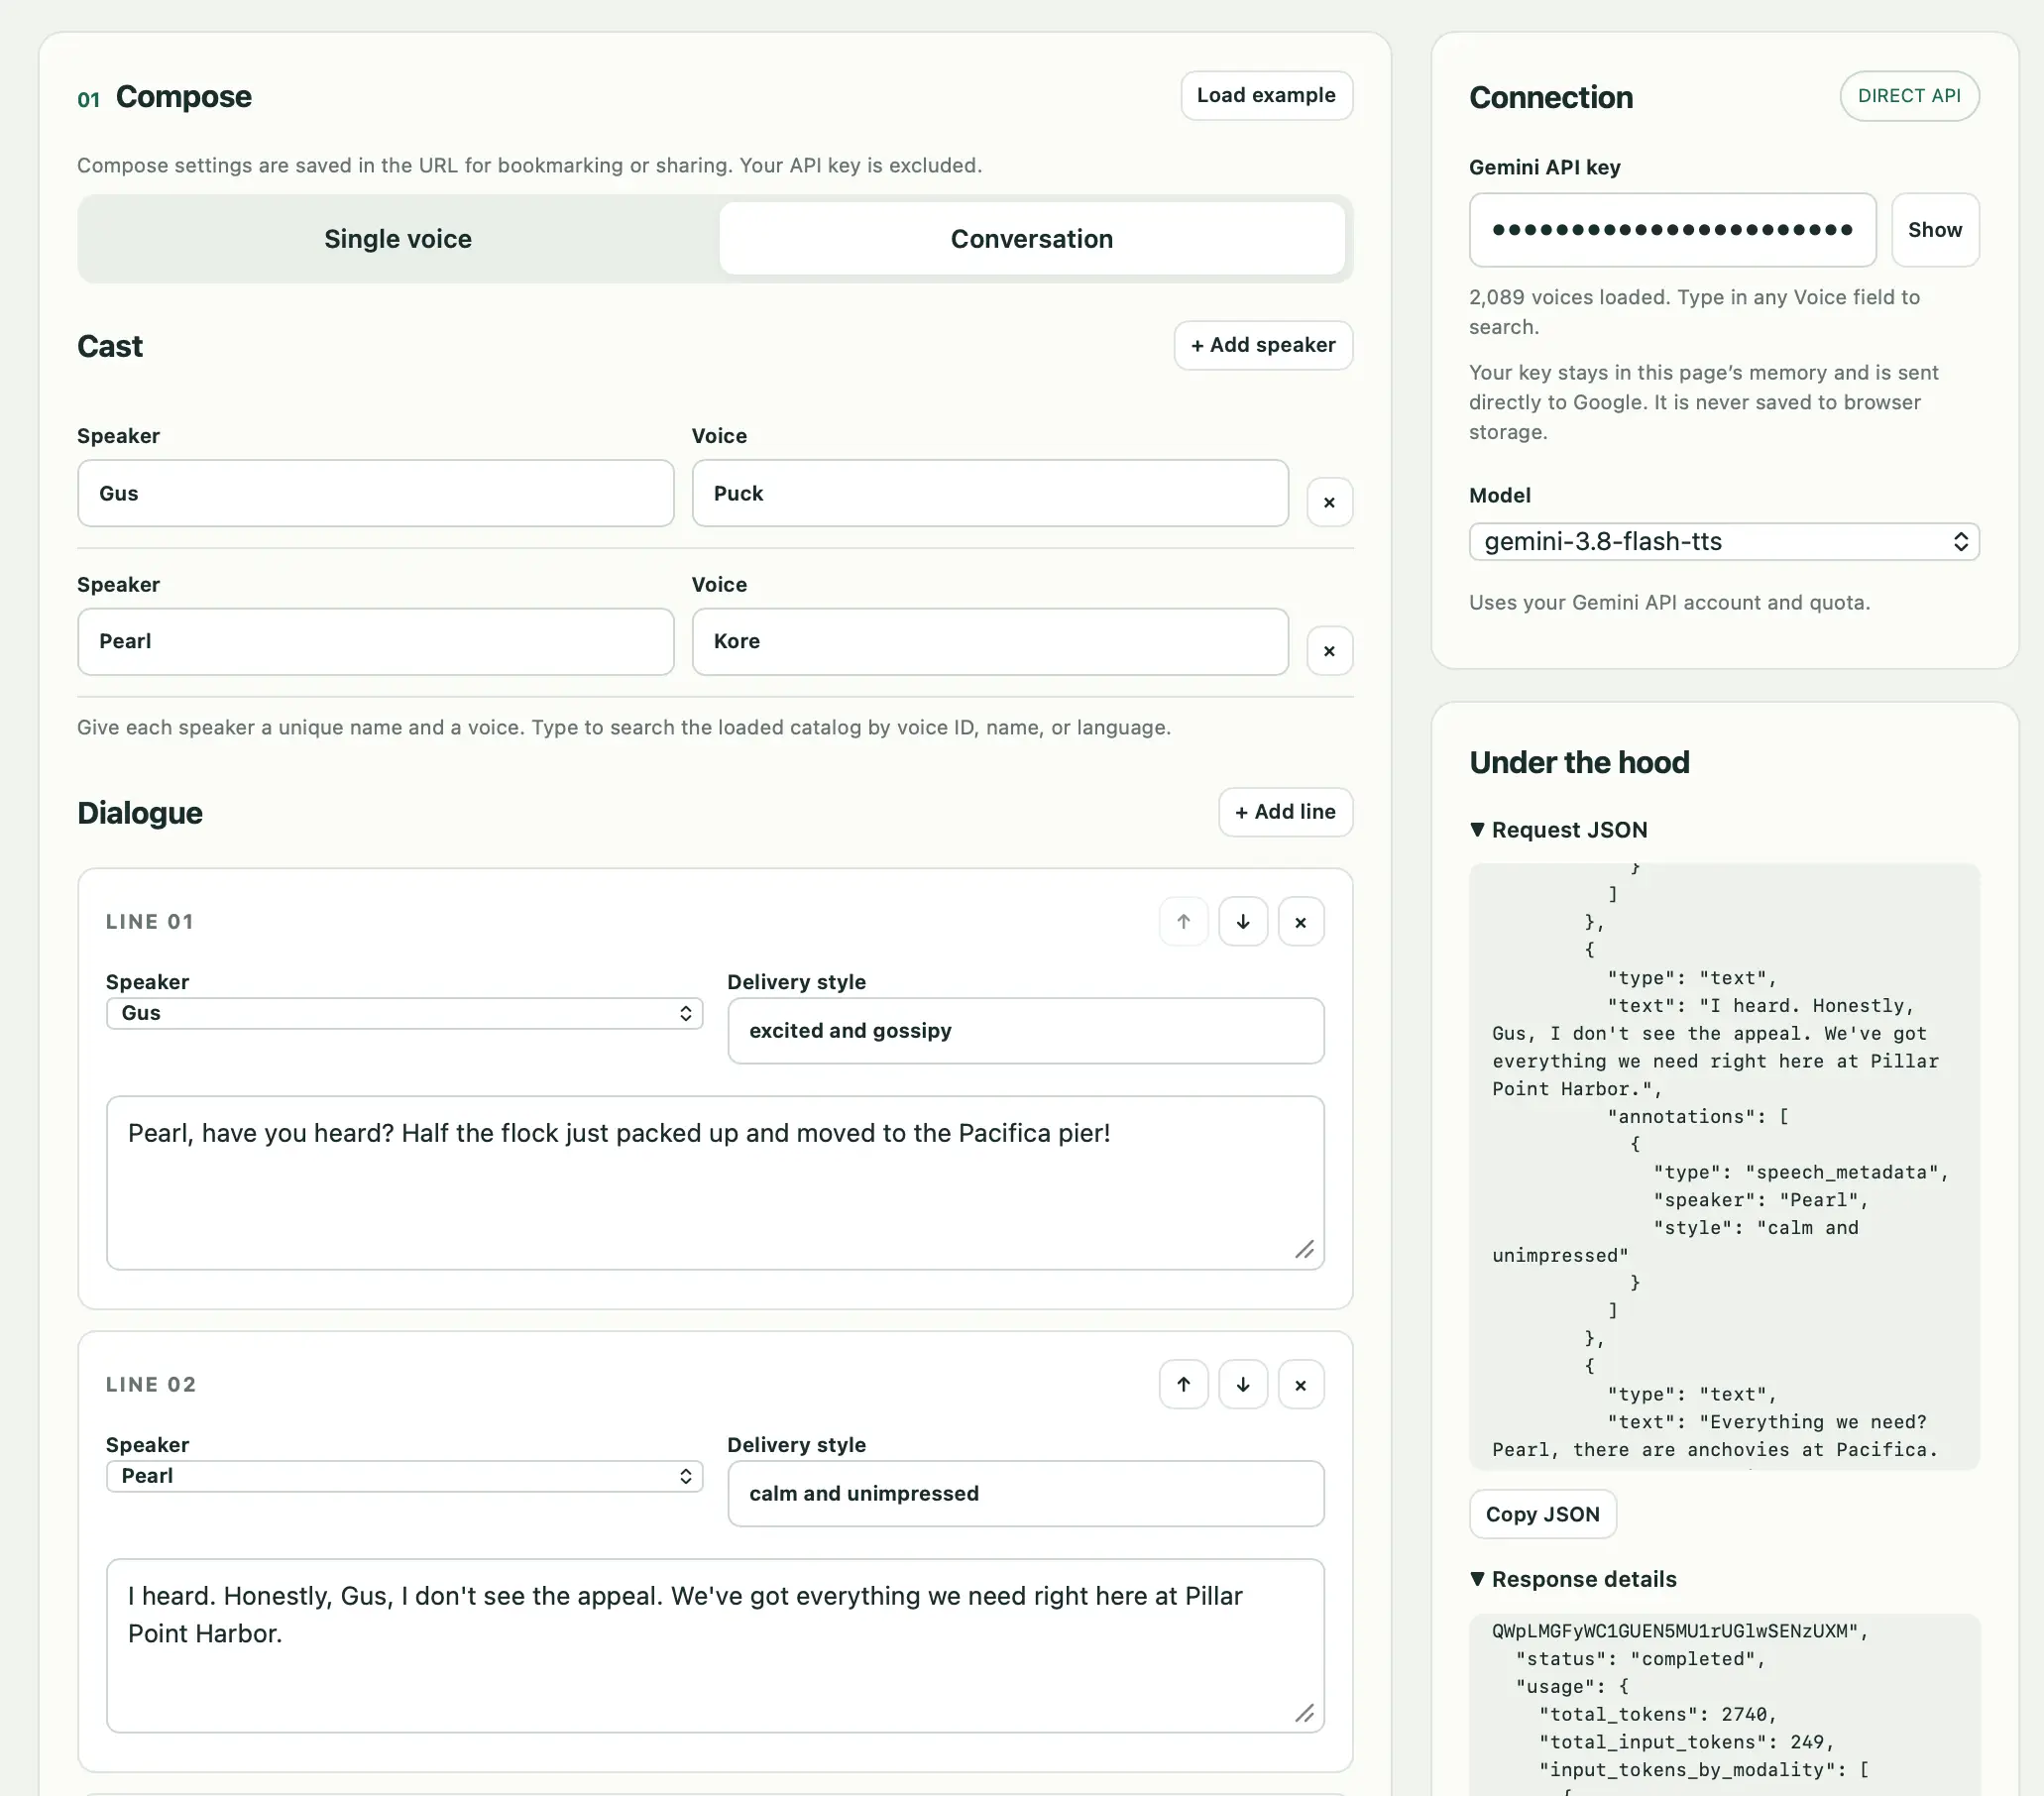
TL;DR. Gemini 3.8 TTS 신모델과 브라우저 기반 멀티보이스 플레이그라운드 소개
- Google, gemini-3.8-flash-tts와 gemini-3.8-flash-lite-tts 공개
- 2,000개 이상 음성 라이브러리와 30초 샘플 기반 커스텀 보이스 생성 지원
- 서로 다른 음성과 스타일 지시를 가진 다중 화자 대화 오디오 생성 용이
왜 중요한가 단일 화자 TTS 데모를 넘어 다중 캐릭터 대화와 커스텀 보이스를 브라우저에서 바로 실험할 수 있다는 점이 핵심이다. 생성 시간과 비용 수치가 함께 제시돼 TTS API의 실제 활용성과 프로토타이핑 난도를 가늠하기 쉽다.
추천 대상 TTS API 활용, 멀티보이스 음성 합성, 브라우저 기반 AI 툴 실험에 관심 있는 개발자
LLMInferenceGenerative
TL;DR. Claude Opus 5.5와 GPT-6 Sol·Luna 공개, 고성능 모델 가격 경쟁 본격화
- OpenAI GPT-6 Luna·Sol 출시와 함께 GPT-5.6 대비 절반 수준 가격 인하, Luna는 입력 $0.10/M·출력 $0.50/M
- Claude Opus 5.5도 입력 $4/M·출력 $20/M로 20% 인하, 캐시 읽기 가격은 60% 하락
- GPT-6 Sol은 입력 $2/M·출력 $10/M로 Grok 4.7과 유사한 입력가, 기존 GPT-5.6 Terra 대체 가능성 부각
왜 중요한가 이번 업데이트는 성능 경쟁보다도 API 단가 재편이 핵심이다. 특히 GPT-6 Luna·Sol의 급격한 가격 인하와 Opus 5.5의 캐시 비용 절감은 에이전트형 워크로드와 앱 빌드 비용 구조에 직접적인 영향을 준다.
추천 대상 LLM API 비용 최적화와 코딩·에이전트용 기본 모델 선택을 고민하는 개발자
r/LocalLLaMA (Top Today) · 1
LLMResearchTooling
TL;DR. Jev의 신기술 주장에 대한 반론, 기존 분류기·제로샷 기법의 재포장 지적
- Jev의 핵심 동작을 제한된 선택지 위 확률 출력으로 설명, 전형적 분류기(classifier) 행태라는 주장
- 자기회귀 생성 부재, 유효하지 않은 클래스 출력 불가, 추론 시점 라벨 정의 가능성 모두 신규성 부족 지적
- 제로샷/NLI 분류기, 임베딩 모델, 크로스 인코더, 리랭커가 수년간 유사 기능 제공했다는 비교
왜 중요한가 새 범주의 의사결정 모델처럼 보이는 주장을 기존 ML 분류·랭킹 기술의 연장선에서 재해석한 글이다. LLM 중심 담론에서 오래된 제로샷·NLI·리랭킹 기법이 과소평가되거나 재포장되는 문제를 짚는다.
추천 대상 제로샷 분류, 리랭커, LLM 기반 의사결정 시스템의 차이를 구분하려는 ML 엔지니어
Hacker News Front Page · 2
AgentOpenSourceTooling
TL;DR. Strands Harness 공개, 범용 에이전트 실행·배포를 1줄 코드로 단순화
- Apache 2.0 오픈소스 범용(agent) 하네스 공개, Python·TypeScript 1줄로 시작 가능
- Claude·GPT 동일 모델 기준 6개 벤치마크에서 다른 하네스 대비 비용 28% 절감, 정확도는 동등 이상
- Fable 5에서 Claude Code 대비 비용 77% 절감, Terminal Bench 2.1 점수는 더 높게 보고
왜 중요한가 로컬에서만 잘 동작하던 코딩 에이전트식 경험을 범용 에이전트 개발·클라우드 배포까지 확장하려는 시도다. 비용 효율을 높이면서 정확도를 유지하는 기본 컨텍스트 관리 전략을 패키지로 제공해, 자체 에이전트 구축의 초기 시행착오를 줄인다.
추천 대상 에이전트 프로토타이핑·배포 자동화와 비용 최적화에 관심 있는 ML/AI 엔지니어
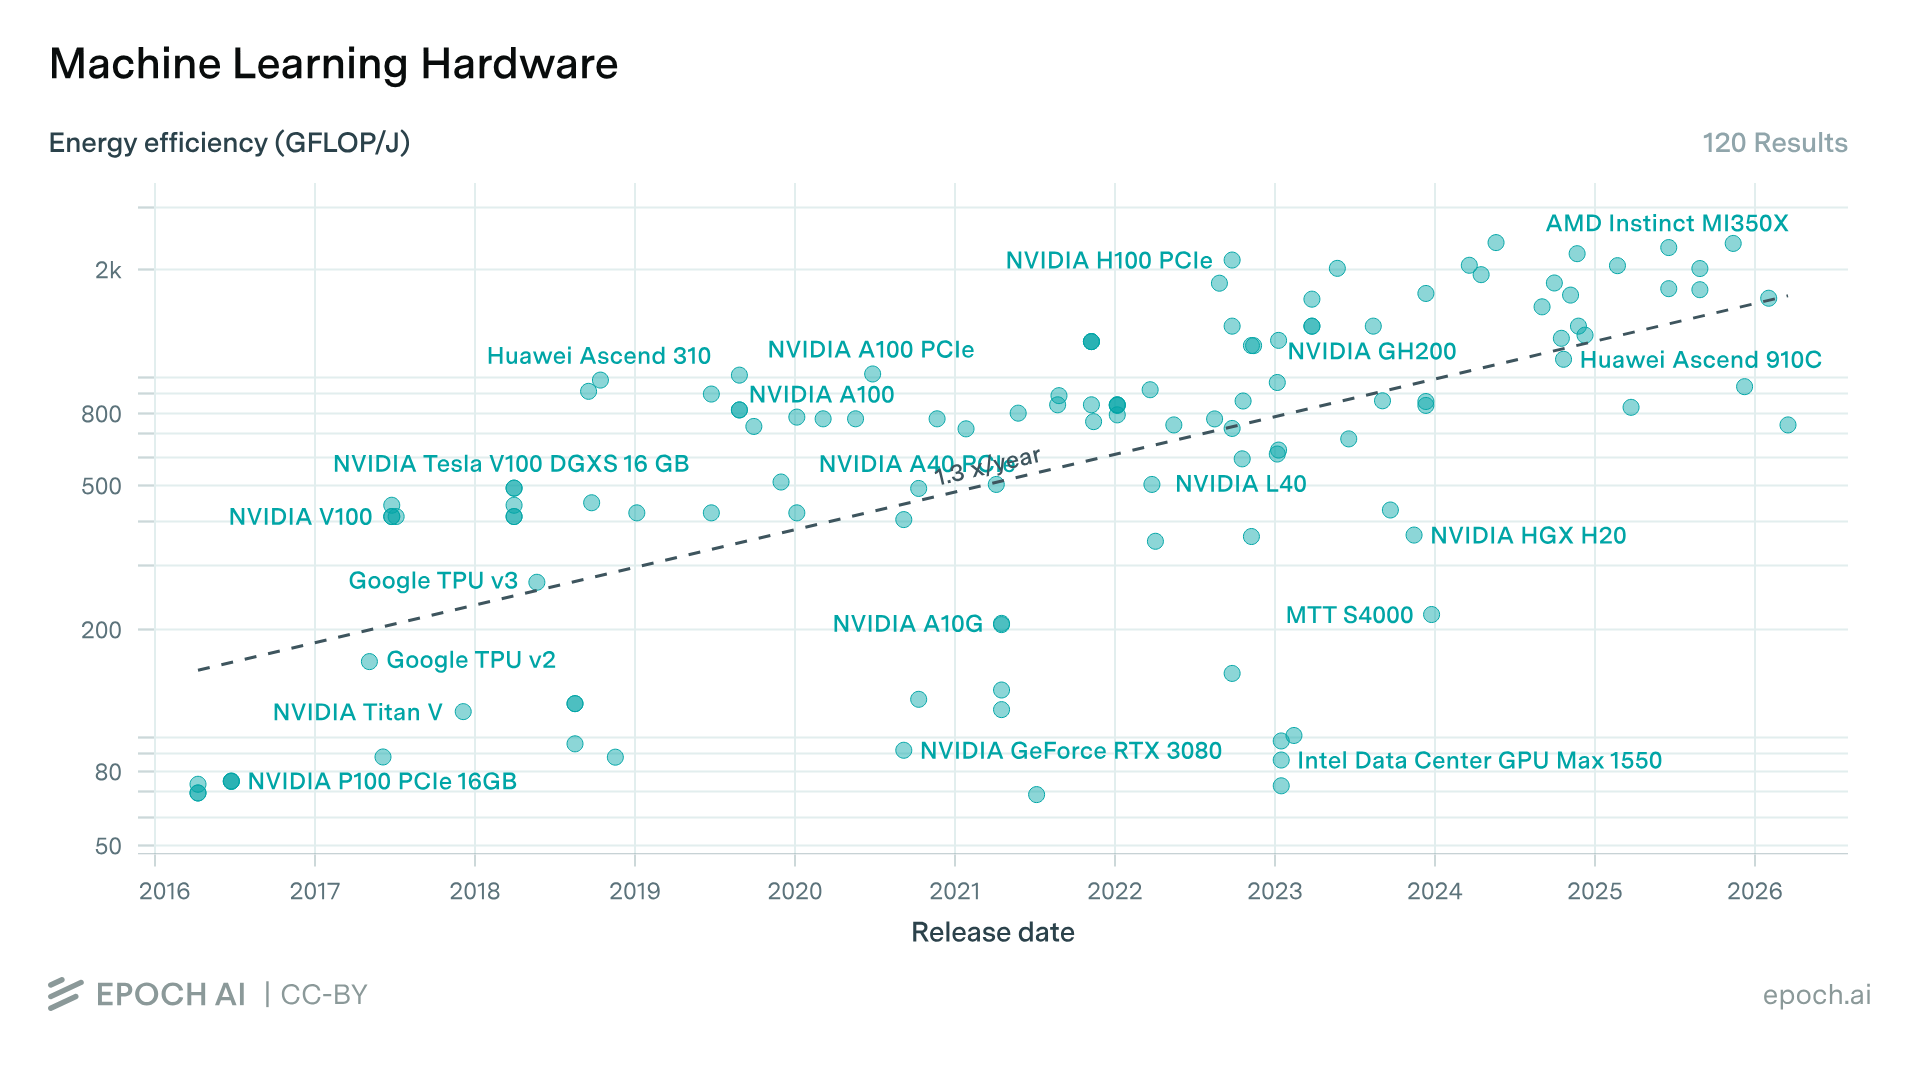
LLMInferenceInfra
TL;DR. 토큰 비용 급락과 효율 개선으로 LLM의 인프라화 전망 정리
- GPU 전력 효율이 세대마다 지수적으로 개선, 약 2년마다 2배 수준 향상 추세 제시
- 모델 가격은 토큰당보다 작업당 비용 기준에서 급락, 2026년에는 2025 대비 두 자릿수 자릿수 이상 저렴해진 사례 제시
- 작은 모델의 저가 토큰이 항상 유리하지 않으며, 전체 작업 완료 비용은 추론·수정 토큰까지 포함해 평가 필요
왜 중요한가 LLM 비용 하락을 단순 토큰 단가가 아니라 작업당 비용, GPU 효율, 추론 엔진 발전까지 묶어 설명한다. AI를 개별 제품이 아니라 컴퓨팅 기본 인프라로 재편할 수 있다는 관점을 뒷받침한다.
추천 대상 LLM 서빙 비용 구조와 로컬 실행 가능성에 관심 있는 ML 엔지니어·플랫폼 팀