| TH—NEWS |
Morning Digest — 2026-09-23
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 새 모델 공개와 추론·서빙 실무 도구가 같이 올라와서, 연구 구경용보다는 바로 업무 감각에 연결되는 읽을거리가 많습니다. 빠르게 훑는다면
Xiaomi, RL 코드와 학습 환경까지 공개한 1.02T 옴니모달 MiMo-V2.6 출시, 오픈소스 지능 지수 1위, AIPerf: 서버 성능 측정 시, 부하 생성기가 병목이 되지 않도록 NVIDIA가 개발 및 공개한 LLM 추론 벤치마크 도구, Simplifying Model Serving Across Multiple GPUs with NVIDIA TensorRT…
🔥 꼭 볼 것
| 01 |
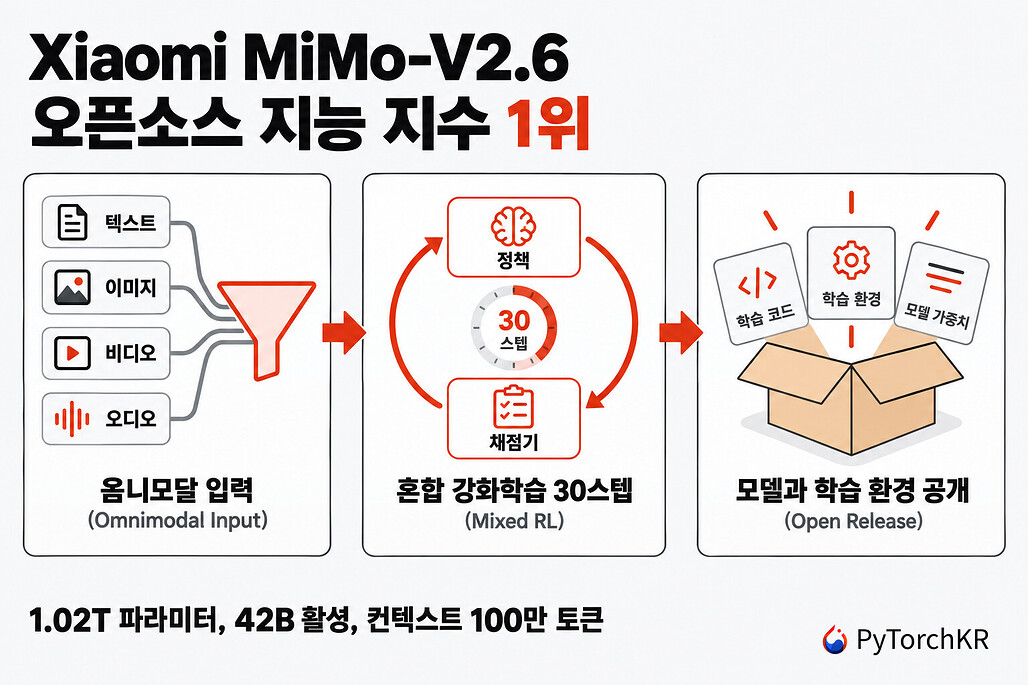 Xiaomi, RL 코드와 학습 환경까지 공개한 1.02T 옴니모달 MiMo-V2.6 출시, 오픈소스 지능 지수 1위 1.02T 옴니모달 MoE와 RL 학습 환경까지 통째로 공개한 대형 오픈소스 발표.
💡 모델뿐 아니라 재현 가능한 학습 스택 공개라 영향이 큽니다.
|
| 02 |
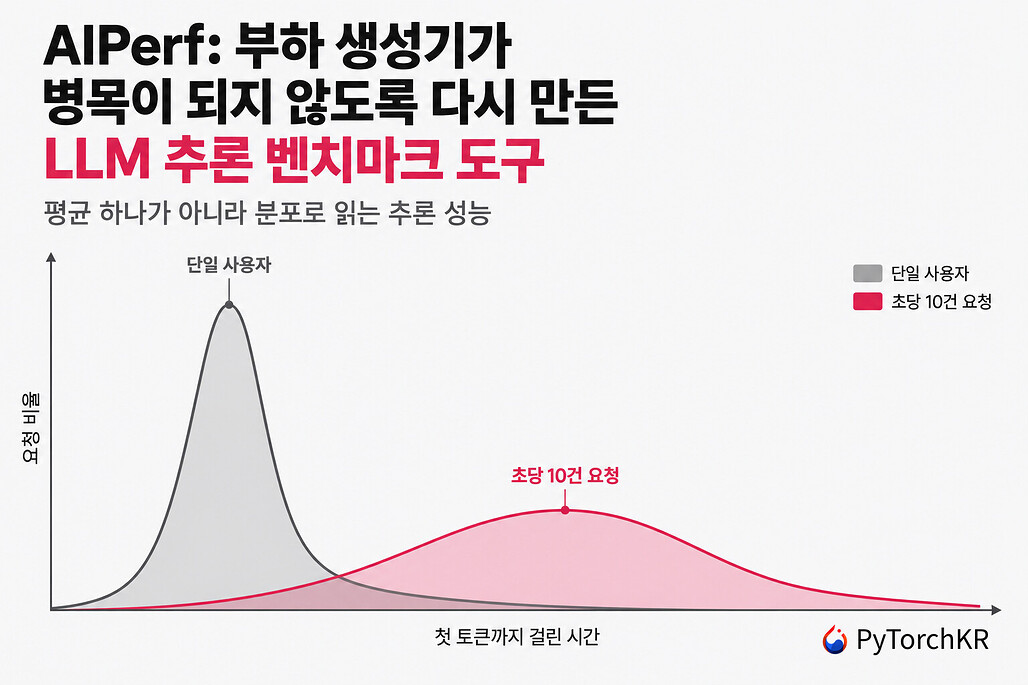 AIPerf: 서버 성능 측정 시, 부하 생성기가 병목이 되지 않도록 NVIDIA가 개발 및 공개한 LLM 추론 벤치마크 도구 부하 생성기 병목을 줄여 LLM 추론 서버 성능을 더 정확히 재는 NVIDIA 벤치 도구.
💡 서빙 성능 측정 신뢰도를 바로 높일 수 있습니다.
|
| 03 |
 Simplifying Model Serving Across Multiple GPUs with NVIDIA TensorRT Multi-Device Integration in NVIDIA Dynamo-Triton Dynamo-Triton에 TensorRT 멀티디바이스 통합으로 다중 GPU 서빙 구성이 단순해집니다.
💡 멀티 GPU 추론 운영 복잡도를 줄이는 실무 팁입니다.
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | agent-substrate/substrate | 에이전트 실행을 위한 Go 기반 코어 시스템 프로젝트 |
| GeekNews | Anthropic 사이트 소스코드에서 발견한 "claude-opus-5-5"라는 페이지 이름, 근데 지금은 흔적도 없이 ... 어제 | Anthropic 뉴스 페이지 소스에서 미공개 추정 모델명 노출 정황 |
| HF Papers | Document Retrieval-Aware Chunking (D-RAC): Universal Retrieval-Aware … | 기업 문서 검색 성능을 높이는 PDF 정규화·멀티모달 마크다운 청킹 기법 |
| HF Papers | onPanda: Efficient Annotation of On-Policy Alignment Data for LLMs an… | 토큰 단위 수정으로 LLM·에이전트 온폴리시 정렬 데이터 주석 효율화 |
| Simon Willison's Weblog | Jev introduces a new shape of LLM - System One, aka Decision Models 어제 | 텍스트 대신 확률·점수만 내는 초저가 결정형 LLM, Jev 등장 |
| r/LocalLLaMA (Top Today) | yandex/AliceAI-Foundation-80B-A3B-Base: Russian-developed competitor … 어제 | 얀덱스의 러시아어 중심 80B 기반 모델 공개, Qwen·DeepSeek 대안 부상 |
| Hacker News Front Page | OpenAI GPT–6 Astra breaks Enigma message that has resisted solution s… 어제 | GPT-6 Astra, 2005년부터 미해독 Enigma 암호문 해독 사례 |
📚 전체 목록 (소스별)
GitHub Trending · 1
agent-substrate/substrate
Go · 301 stars today · ⭐ 2,915
AgentInfraOpenSource
TL;DR. 에이전트 실행을 위한 Go 기반 코어 시스템 프로젝트
- GitHub Trending 등재 저장소, Agent Substrate의 핵심 시스템 코드베이스
- Go 언어 기반 구현, 경량 백엔드·시스템 프로그래밍 친화적 선택지
- 저장소 지표 기준 2,915 스타, 하루 301 스타 증가로 초기 관심도 확인
왜 중요한가 에이전트 시스템은 모델 자체보다 실행 기반과 오케스트레이션 구조가 성능·운영성을 좌우하는 경우가 많다. 이 프로젝트는 에이전트용 코어 시스템을 표방해, 관련 인프라 스택을 찾는 개발자에게 참고 기준이 될 수 있다.
추천 대상 에이전트 런타임·백엔드 인프라 구현에 관심 있는 Go 개발자와 ML 엔지니어
PyTorch KR 읽을거리 · 2
LLMMultimodalOpenSource
TL;DR. 샤오미, 1.02T 옴니모달 MoE MiMo-V2.6과 RL 환경 전면 공개
- MiMo-V2.6-Pro 1.02T 파라미터 중 42B 활성, Flash 310B 중 15B 활성, 두 모델 모두 1M 토큰 컨텍스트 지원
- 텍스트·이미지·영상·음성 통합 옴니모달 구조와 384개 전문가 중 8개 활성 MoE, MTP 기반 투기적 디코딩 적용
- 6일 미만 30스텝 RL과 약 75만 궤적 학습 수행, Pro 비용 262만달러·Flash 85만달러, DeepSWE v1.1 점수 각각 72.57·65.68
왜 중요한가 오픈 웨이트 공개를 넘어 RL 사후학습 레시피와 환경까지 함께 연 사례라는 점이 핵심입니다. 대규모 RL 계산량 확대와 그룹 단위 보상 설계가 오픈소스 모델의 성능 상한을 얼마나 끌어올릴 수 있는지 보여줍니다.
추천 대상 오픈소스 LLM, 멀티모달 RL, 사후학습 재현성에 관심 있는 ML 엔지니어
InferenceBenchmarkTooling
TL;DR. 부하 생성기 병목을 줄인 NVIDIA 공개 LLM 추론 벤치마크 도구 AIPerf
- 서버 성능 측정 시 벤치마크 클라이언트가 병목이 되는 문제를 겨냥한 LLM 추론 평가 도구
- NVIDIA가 개발·공개한 AIPerf 소개 중심 콘텐츠, 부하 생성기 영향 최소화 목적
- LLM 서버의 실제 추론 처리 성능을 더 정확히 측정하기 위한 벤치마크 접근 제시
왜 중요한가 LLM 추론 서버 벤치마크에서는 모델 서버보다 요청을 보내는 부하 생성기가 먼저 한계에 도달해 결과를 왜곡하는 경우가 많습니다. AIPerf는 이 지점을 겨냥해 측정 신뢰도를 높이려는 도구라는 점에서 운영·최적화 비교의 기준을 개선할 수 있습니다.
추천 대상 LLM 추론 서버 성능 측정과 서빙 벤치마크 신뢰도에 관심 있는 ML 엔지니어
GeekNews 최신 · 1

LLMToolingTech
TL;DR. Anthropic 뉴스 페이지 소스에서 미공개 추정 모델명 노출 정황
- anthropic.com/news의 view-source 라우팅 데이터에서 페이지 이름 목록 노출 정황
- "claude-opus-5-5", "claude-fable" 등 미공개 추정 식별자 포함 스크린샷 공유
- 현재는 해당 흔적이 사라진 상태로, 일시적 노출 또는 정리 가능성 시사
왜 중요한가 공개 전 페이지 식별자나 라우팅 정보가 프런트엔드 소스에 남으면 제품 로드맵 추정 단서가 될 수 있다. 모델 출시 자체가 확인된 것은 아니지만, 웹 배포 과정의 메타데이터 노출 리스크를 보여주는 사례다.
추천 대상 LLM 벤더 동향과 웹 배포 메타데이터 노출 이슈를 보는 개발자
HuggingFace Daily Papers · 2

Document Retrieval-Aware Chunking (D-RAC): Universal Retrieval-Aware Ingestion of Enterprise Documents via PDF Normalization and Multimodal Markdown Conversion
arXiv
RAGMultimodalResearch
TL;DR. 기업 문서 검색 성능을 높이는 PDF 정규화·멀티모달 마크다운 청킹 기법
- D-RAC 제안: 문서 검색(document retrieval) 관점을 반영한 범용 엔터프라이즈 문서 수집·청킹 파이프라인
- PDF 정규화와 멀티모달 마크다운 변환을 결합해 문서 구조·시각 요소를 검색 친화적으로 재구성
- 청킹 이전 단계의 ingestion 품질을 개선해 다양한 기업 문서에서 검색 정확도와 활용성을 높이는 접근
왜 중요한가 기업 문서는 PDF 구조 붕괴, 표·이미지 혼합, 일관성 없는 레이아웃 때문에 검색 성능이 쉽게 저하된다. 이 작업은 청킹 자체보다 앞단의 정규화와 변환을 retrieval-aware하게 설계해 엔터프라이즈 RAG의 기초 품질 문제를 겨냥한다.
추천 대상 사내 문서 검색, 엔터프라이즈 RAG, PDF 기반 지식베이스 구축에 관심 있는 ML 엔지니어

onPanda: Efficient Annotation of On-Policy Alignment Data for LLMs and Agents via Token-Level Correction
arXiv
LLMAgentResearch
TL;DR. 토큰 단위 수정으로 LLM·에이전트 온폴리시 정렬 데이터 주석 효율화
- onPanda 제안: LLM과 에이전트용 온폴리시(on-policy) 정렬 데이터 주석을 토큰 수준 교정으로 수행하는 접근
- 전체 응답 재작성 대신 토큰 단위 수정 중심 설계로 데이터 라벨링 비용과 주석 비효율 완화 목표
- 정렬(alignment) 데이터 구축 과정에서 모델 출력 보정 루프를 더 세밀하게 다루는 방법론 제시
왜 중요한가 온폴리시 정렬은 현재 모델이 생성한 출력을 바탕으로 데이터를 쌓아야 해 주석 비용이 커지기 쉽다. 전체 응답을 다시 쓰는 대신 토큰 단위로 고치는 방식은 사람 개입을 줄이면서 더 촘촘한 피드백 신호를 만들 수 있다는 점에서 의미가 있다.
추천 대상 LLM 정렬 데이터셋 구축, RLHF/후속 정렬, 에이전트 학습 파이프라인에 관심 있는 ML 엔지니어
AI Lab Blogs · 1
InferenceInfraLLM
TL;DR. Dynamo-Triton에 TensorRT 멀티디바이스 추론을 통합한 다중 GPU 서빙 단순화
- 생성형 AI의 연산·메모리 요구가 단일 GPU 한계를 넘는 상황에서 다중 GPU 추론 경로 제시
- NVIDIA TensorRT multi-device inference를 NVIDIA Dynamo-Triton에 통합해 모델 서빙 구성 복잡도 완화
- 멀티 GPU 환경에서 단일 시스템처럼 추론 자원을 활용하는 서빙 방식 소개
왜 중요한가 대규모 생성형 모델은 단일 GPU 메모리와 처리량 한계에 자주 부딪힌다. TensorRT의 멀티디바이스 추론을 Triton 계열 서빙에 직접 연결해 다중 GPU 운영 복잡도를 낮추는 점이 실무적으로 의미가 있다.
추천 대상 다중 GPU 기반 LLM·생성형 모델 서빙 최적화에 관심 있는 ML 인프라 엔지니어
Simon Willison's Weblog · 1
LLMInferenceResearch
TL;DR. 텍스트 대신 확률·점수만 내는 초저가 결정형 LLM, Jev 등장
- 비정형 입력을 받아 yes/no, 선택지, 연속 점수와 신뢰도로 반환하는 결정 모델(decision model) 형태
- 출력 토큰 과금 없이 입력만 과금하는 API 구조, 100만 토큰당 0.042달러로 GPT-5 Nano보다 저렴
- 단일 state에 여러 질문을 함께 넣고 병렬 평가 가능, 분류·라벨링·우선순위화·검색 재랭킹에 적합
왜 중요한가 텍스트 생성 대신 확률적 의사결정만 반환해 분류·스코어링 작업에 맞춘 LLM의 새로운 사용 형태를 보여준다. 매우 낮은 비용과 병렬 질의가 장점이지만, 설명 부족과 편향 검증이 더 중요해진다는 점도 함께 드러낸다.
추천 대상 LLM을 분류·랭킹·리랭킹 파이프라인에 붙이려는 ML 엔지니어와 검색/추천 담당자
r/LocalLLaMA (Top Today) · 1
LLMOpenSourceInference
TL;DR. 얀덱스의 러시아어 중심 80B 기반 모델 공개, Qwen·DeepSeek 대안 부상
- yandex/AliceAI-Foundation-80B-A3B-Base 공개, 러시아 개발 모델로 Qwen 35B·DeepSeek V4 Flash 경쟁 구도
- Qwen3 파인튜닝이 아닌 자체 설계(custom architecture) 기반 모델이라는 점이 핵심 차별점
- Qwen 3.5·3.6 계열처럼 post-training이 적용된 모델은 아니라는 커뮤니티 언급
왜 중요한가 중국계 공개모델 중심이던 대형 LLM 선택지에 러시아 개발 독자 아키텍처 모델이 추가됐다는 점이 의미다. 다만 post-training 부재와 llama.cpp 미지원으로 실제 활용성 평가는 추가 검증이 필요하다.
추천 대상 비영어권 LLM 생태계와 공개 대형 모델 비교에 관심 있는 ML 엔지니어
Hacker News Front Page · 1
LLMSecurityResearch
TL;DR. GPT-6 Astra, 2005년부터 미해독 Enigma 암호문 해독 사례
- OpenAI GPT-6 Astra가 2005년 이후 풀리지 않던 Enigma 메시지 해독 사례 공개
- 전통적 수작업·전문가 분석으로 장기간 남아 있던 고전 암호 문제 해결 맥락
- LLM이 역사적 암호 해독 과정에서 가설 생성·탐색 보조 도구로 쓰일 가능성 부각
왜 중요한가 현대 LLM이 단순 텍스트 생성 beyond, 제약이 큰 퍼즐·암호 문제에도 활용될 수 있음을 보여주는 사례다. 다만 일반화된 암호해독 성능으로 보기보다 특정 문제 해결 사례로 해석할 필요가 있다.
추천 대상 LLM의 비정형 문제 해결 능력과 보안·암호 응용 가능성에 관심 있는 엔지니어