| TH—NEWS |
Morning Digest — 2026-09-21
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 에이전트 개발, 로컬·온디바이스 추론, 모델 평가처럼 손에 바로 닿는 실전형 읽을거리가 많아요. 가볍게 훑기엔 조금 아깝고, 실제로 써보거나 성능 감각을 업데이트할 만한 글이 섞여 있어서 3개만 골라 읽어도 수확이 있는 날입니다. 특히
BuilderIO/agent-native, Splash: 범용 엔진 대신 모델마다 커널과 초안 모델을 새로 만드는 Apple Silicon 추론 엔진, Qwen Image 2.1 쪽은 바로 체감 포인트가 분명해요.
🔥 꼭 볼 것
| 01 | |
| 02 | |
| 03 |
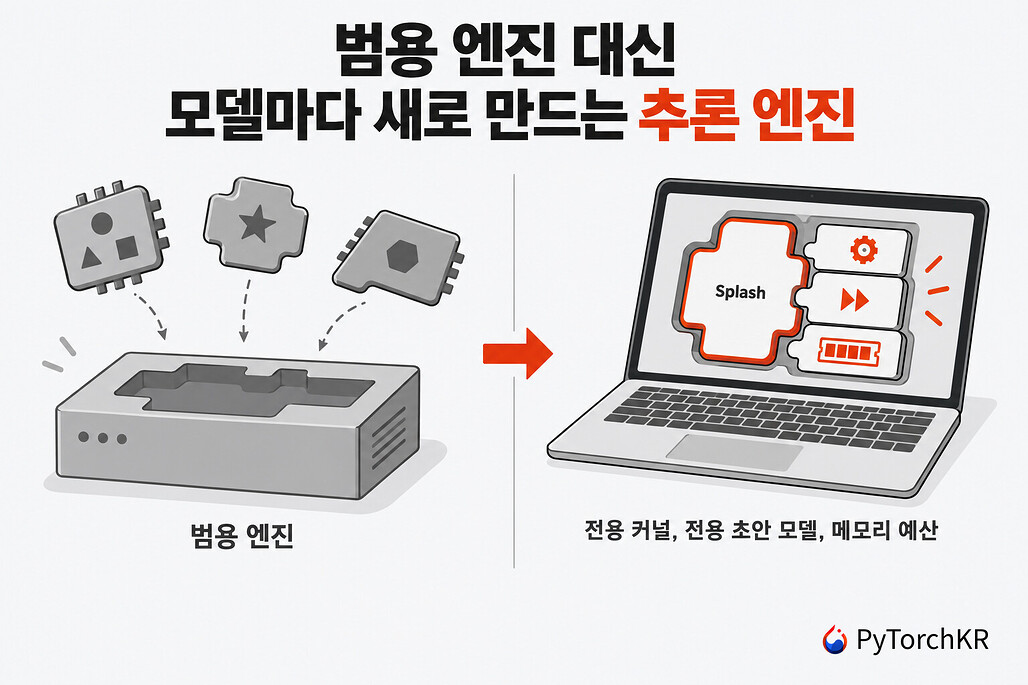 Splash: 범용 엔진 대신 모델마다 커널과 초안 모델을 새로 만드는 Apple Silicon 추론 엔진 Apple Silicon에서 모델별 최적화로 추론 성능을 끌어올리려는 접근입니다.
💡 맥 기반 로컬 추론 성능 전략을 보는 데 유용함.
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| PyTorch KR | kev: 비공개 모델 Jev를 Qwen과 LoRA로 재현해 맥북에서 학습하고 실행하는 결정 모델 어제 | 비공개 Jev를 Qwen+LoRA로 재현해 맥북 학습·실행한 결정 모델 공개 |
| GeekNews | px0 - 브라우저에서 코드를 빠르게 탐색하고 검토하는 초경량 도구 어제 | 브라우저 기반 초경량 원격 코드 탐색·리뷰 도구 px0 공개 |
| HF Papers | Can MiniMax-H3 Reason About the Physical World? An Evaluation of Omni… | MiniMax-H3의 물리 세계 추론 능력을 점검한 옴니모달 평가 연구 |
| HF Papers | When EOS Tokens Disagree: Understanding Length Inflation in On-Policy… | 온폴리시 증류에서 EOS 불일치가 응답 길이 팽창을 유발하는 원인 분석 |
| Simon Willison's Weblog | Quoting voxium | 대기업 현장의 Claude Code 강제 도입과 AI 개발 문화 붕괴 사례 인용 |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| PyTorch KR | JEV 에코시스템 해부 — 답변 검증기 13종을 한 시험지에 세우면 무엇이 보이는가? 어제 | 13개 답변 검증기를 동일 시험지로 비교한 typed decision 리더보드 분석 |
| r/LocalLLaMA (Top Today) | Lawsuit says Anthropic, OpenAI, SpaceXAI and Google made illegal agre… | Anthropic·OpenAI·xAI·Google의 AI 개발 지연 담합 주장 소송 제기 |
📚 전체 목록 (소스별)
GitHub Trending · 1
BuilderIO/agent-native
TypeScript · 89 stars today · ⭐ 5,150
AgentOpenSourceTooling
TL;DR. 에이전트형 앱 개발을 위한 TypeScript 프레임워크
- BuilderIO가 공개한 agentic app 구축용 오픈소스 프레임워크
- GitHub 기준 TypeScript 프로젝트, 누적 스타 5,150개·당일 89개 증가
- 에이전트 기반 애플리케이션 개발을 위한 구조와 개발 출발점 제공
왜 중요한가 에이전트 앱 수요가 늘면서 반복 구현되는 실행 흐름과 앱 구조를 프레임워크로 묶으려는 시도라는 점이 핵심이다. TypeScript 생태계에서 빠르게 시작할 수 있는 기반 도구로 관심을 받을 만하다.
추천 대상 TypeScript 기반 에이전트 앱 프로토타이핑과 구조화에 관심 있는 개발자
PyTorch KR 읽을거리 · 3
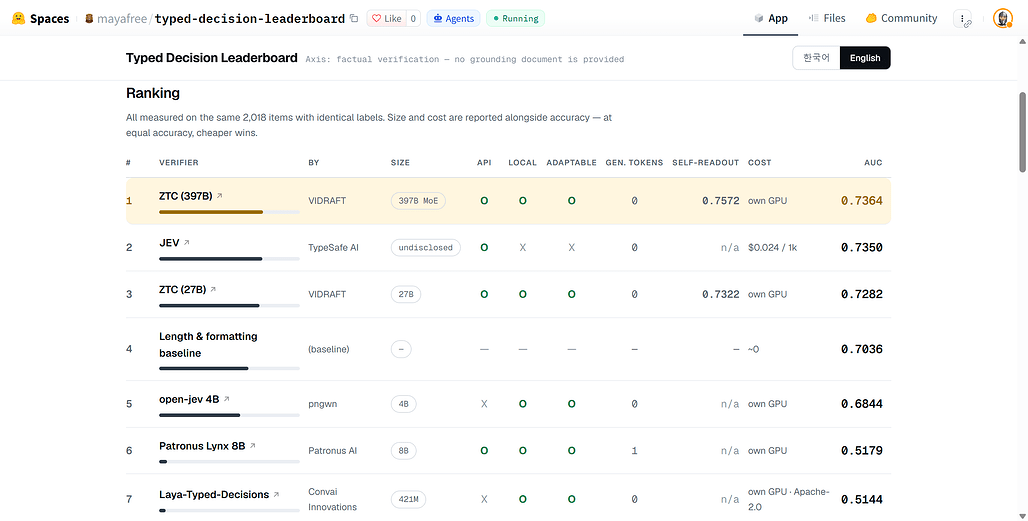
BenchmarkLLMResearch
TL;DR. 13개 답변 검증기를 동일 시험지로 비교한 typed decision 리더보드 분석
- mayafree의 Typed Decision Leaderboard가 13개 시스템을 2,018문항·동일 라벨·동일 채점 코드로 비교
- 상위권은 ZTC 397B 0.7364, JEV 0.7350, ZTC 27B 0.7282로 1·2위 차이는 통계적으로 비유의
- 길이·서식만 보는 기준선이 AUC 0.7036으로 13개 중 8개가 하회, 실질 합격선이 0.5가 아닌 0.7036
왜 중요한가 각자 자기 벤치마크에서 1위를 주장하던 답변 검증기들을 같은 조건에서 비교해 실질 성능과 기준선을 드러낸 사례다. 특히 AUC가 높아도 에이전트 재시도 관문으로는 성능이 달라질 수 있어, 검증기 선택 시 오프라인 지표만 보면 안 된다는 점을 보여준다.
추천 대상 에이전트 검증기·LLM judge·typed decision 모델 평가에 관심 있는 ML 엔지니어
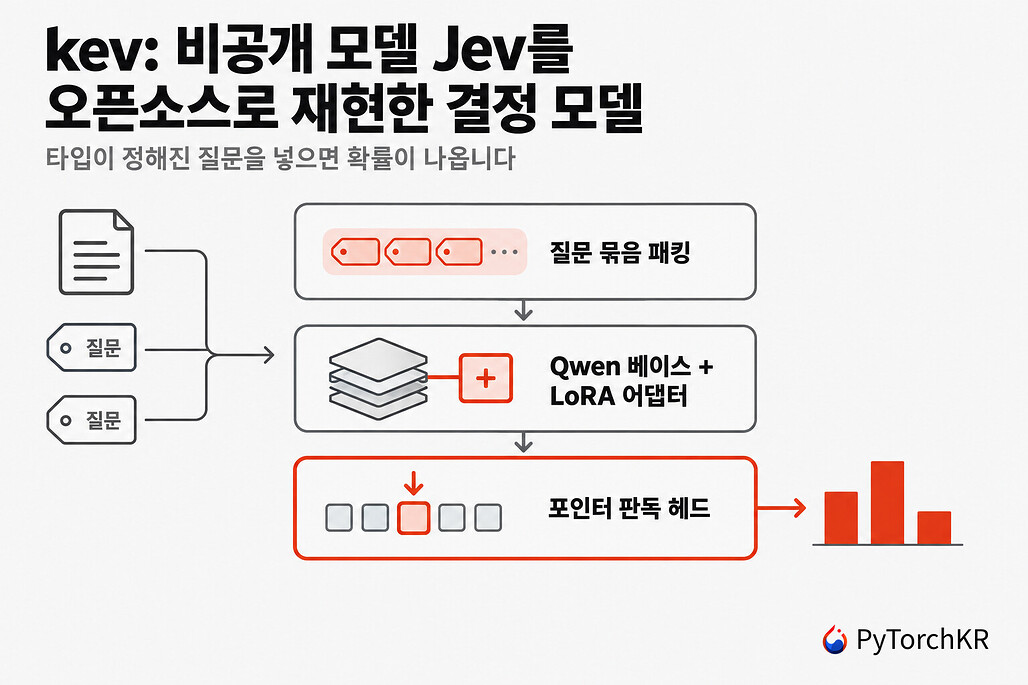
LLMFine-tuningOpenSource
TL;DR. 비공개 Jev를 Qwen+LoRA로 재현해 맥북 학습·실행한 결정 모델 공개
- 비공개 모델 Jev의 동작을 Qwen 기반과 LoRA 미세조정으로 재현한 결정 모델 소개
- 맥북 환경에서 학습과 실행이 가능하도록 구성한 경량 실험·구현 사례
- 폐쇄형 모델을 오픈 모델 스택으로 대체·검증하는 접근에 초점
왜 중요한가 비공개 모델의 능력을 오픈 모델과 LoRA 조합으로 재현하려는 시도라는 점이 핵심이다. 고성능 서버 없이 맥북에서 학습·실행 가능성을 보여 로컬 AI 실험의 진입장벽을 낮춘다.
추천 대상 Qwen 기반 LoRA 미세조정과 로컬 LLM 실행에 관심 있는 개발자·ML 엔지니어
InferenceInfraLLM
TL;DR. Apple Silicon용 모델별 커널·초안 모델 재설계 기반 추론 엔진 Splash
- 범용 추론 엔진 대신 모델마다 전용 커널과 speculative decoding용 초안 모델을 함께 설계하는 접근
- Apple Silicon 특성에 맞춘 최적화로 공통 런타임 오버헤드를 줄이고 모델별 성능을 직접 끌어내는 구조
- 초안 모델과 메인 모델 조합을 통해 추론 지연을 낮추는 speculative decoding 활용 사례에 초점
왜 중요한가 대부분의 추론 스택이 범용 런타임과 공통 커널에 의존하는 것과 달리, Splash는 모델별 재설계를 전제로 성능을 확보한다. Apple Silicon처럼 제약과 특성이 뚜렷한 환경에서 맞춤형 추론 최적화가 얼마나 중요한지 보여주는 사례다.
추천 대상 온디바이스 LLM 추론 최적화와 Apple Silicon 배포에 관심 있는 ML 엔지니어
GeekNews 최신 · 1
CodingToolingOpenSource
TL;DR. 브라우저 기반 초경량 원격 코드 탐색·리뷰 도구 px0 공개
- 1ms 미만 시작 시간과 약 20MB RAM 사용량을 내세운 읽기 최적화(remote-first) 코드 뷰어
- 브라우저에서 심볼 단위 탐색, 퍼지 파일 검색, 워크스페이스 정규식 검색, Git diff 검토 지원
- 5만+ 파일 저장소와 40만 줄 파일도 가상 DOM 기반 윈도잉으로 저부하 탐색 가능
왜 중요한가 AI 코딩 에이전트 확산으로 직접 작성보다 검토·탐색 비중이 커진 흐름에 맞춘 도구다. 무거운 원격 IDE나 확장 생태계 없이 대형 코드베이스를 빠르게 확인하고, 필요한 수정만 외부 에이전트에 넘기는 워크플로를 제시한다.
추천 대상 원격 서버 코드 리뷰, 대형 저장소 탐색, AI 생성 코드 검증 흐름을 가볍게 만들고 싶은 개발자
HuggingFace Daily Papers · 2

MultimodalReasoningResearch
TL;DR. MiniMax-H3의 물리 세계 추론 능력을 점검한 옴니모달 평가 연구
- 옴니모달 생성 모델 MiniMax-H3의 물리 세계 이해·추론 가능성에 초점을 둔 평가 연구
- 텍스트를 넘어 물리적 상식과 세계 모델링 관점에서 모델 성능을 점검한 접근
- 시각·언어 등 복합 입력을 다루는 생성 모델의 추론 한계와 강점을 분석하는 문제의식
왜 중요한가 멀티모달 모델이 단순 인식이나 생성뿐 아니라 물리 세계에 대한 일관된 추론을 할 수 있는지는 실제 활용의 핵심 과제다. 이런 평가는 모델 데모 성능과 실제 세계 이해 능력 사이의 간극을 드러내는 데 의미가 있다.
추천 대상 멀티모달 LLM 평가, 세계 모델링, 물리 추론 벤치마크에 관심 있는 연구자·엔지니어

LLMTrainingResearch
TL;DR. 온폴리시 증류에서 EOS 불일치가 응답 길이 팽창을 유발하는 원인 분석
- 온폴리시 증류(on-policy distillation) 과정에서 EOS 토큰 불일치와 길이 증가 현상 간 상관관계 분석
- 학생·교사 모델의 종료 신호 차이가 응답 종료 시점 왜곡과 불필요한 토큰 생성으로 이어지는 문제 조명
- 길이 팽창(length inflation)을 단순 생성 성향이 아닌 학습 목표·시퀀스 종료 처리 문제로 해석하는 관점 제시
왜 중요한가 증류 학습에서 응답이 길어지는 현상은 비용 증가와 품질 저하로 이어질 수 있다. 이 논문은 이를 EOS 토큰 불일치라는 구체적 메커니즘으로 설명해, 데이터나 모델 크기 외의 학습 설계 이슈를 점검할 단서를 제공한다.
추천 대상 LLM 증류, RL 계열 후속학습, 응답 길이 제어 이슈를 다루는 ML 엔지니어
Simon Willison's Weblog · 1
LLMProductivityHCI
TL;DR. 대기업 현장의 Claude Code 강제 도입과 AI 개발 문화 붕괴 사례 인용
- 대기업 신규 입사자가 전한 현장 증언 중심의 짧은 인용 포스트
- 스펙, 코드, 테스트, PRD, 티켓, 리포트까지 Claude Code가 생성한다는 주장
- 팀 전반이 산출물 검토 없이 AI와 대화만 반복하며 12~13시간 근무한다는 문제 제기
왜 중요한가 생성형 AI를 개발 프로세스 전반에 무비판적으로 밀어 넣었을 때 어떤 조직적 부작용이 생기는지 보여주는 현장 사례다. 생산성 도구의 도입 자체보다 검토 책임, 품질 관리, 조직 문화가 더 중요하다는 점을 환기한다.
추천 대상 AI 코딩 도구 도입 정책과 개발 생산성 지표를 고민하는 엔지니어링 리더
r/LocalLLaMA (Top Today) · 1
TechSecurity
TL;DR. Anthropic·OpenAI·xAI·Google의 AI 개발 지연 담합 주장 소송 제기
- Anthropic, OpenAI, xAI, Google이 AI 개발 속도 저하를 위한 불법 합의를 맺었다는 소송 주장
- 출처는 Reddit r/LocalLLaMA 게시물이며, 본문 메타만으로는 소장 내용과 증거 수준 확인 어려움
- 기술 발표가 아닌 규제·경쟁 이슈 성격의 포스트로 AI 산업 거버넌스와 시장 구조 논점 부각
왜 중요한가 주요 AI 기업 간 담합 의혹은 모델 출시 속도, 경쟁 구도, 규제 논의에 직접 영향을 줄 수 있다. 다만 현재 제공된 정보는 제목 중심이라 사실관계와 법적 쟁점은 원문 확인이 필요하다.
추천 대상 AI 정책·규제, 빅테크 경쟁 구도, 모델 출시 전략 변화에 관심 있는 개발자
Hacker News Front Page · 1

GenerativeVisionMultimodal
TL;DR. Qwen Image 2.1 공개, 이미지 생성·편집 성능과 활용성 확장
- Qwen 팀의 이미지 모델 Qwen Image 2.1 발표 소식
- 텍스트-이미지 생성과 편집 계열 업데이트가 핵심인 릴리스
- Qwen 생태계 확장 맥락의 멀티모달 모델 포트폴리오 강화
왜 중요한가 Qwen 계열이 텍스트 중심을 넘어 이미지 생성·편집까지 확장되는 흐름이라는 점에서 의미가 있다. 생성형 이미지 워크플로와 멀티모달 제품 개발에서 선택지가 넓어질 수 있다.
추천 대상 이미지 생성 모델, 멀티모달 제품 기획, Qwen 생태계 동향을 보는 개발자