| TH—NEWS |
Morning Digest — 2026-09-17
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 실서비스에 바로 닿는 도구·성능 소식이 많아서, 바쁜 개발자라면 가볍게 넘기기보다 몇 개는 꼭 찍어볼 만합니다. 특히
Tencent/WeKnora, TensorRT Edge-LLM Completes the MLPerf Edge Agentic Benchmark 6.4x Faster on Jetson AGX Thor, Training a 4B model to produce 81% faster query plans than Postgres처럼 RAG 플랫폼, 엣지 추론, 데이터베이스 최적화까지 손에 잡히는 주제가 눈에 띄어요.
🔥 꼭 볼 것
| 01 | |
| 02 |
 TensorRT Edge-LLM Completes the MLPerf Edge Agentic Benchmark 6.4x Faster on Jetson AGX Thor Jetson AGX Thor에서 에이전트 워크로드를 MLPerf 기준 6.4배 빠르게 처리.
💡 온디바이스 AI 성능·배포 판단에 직접 영향이 큼.
|
| 03 |
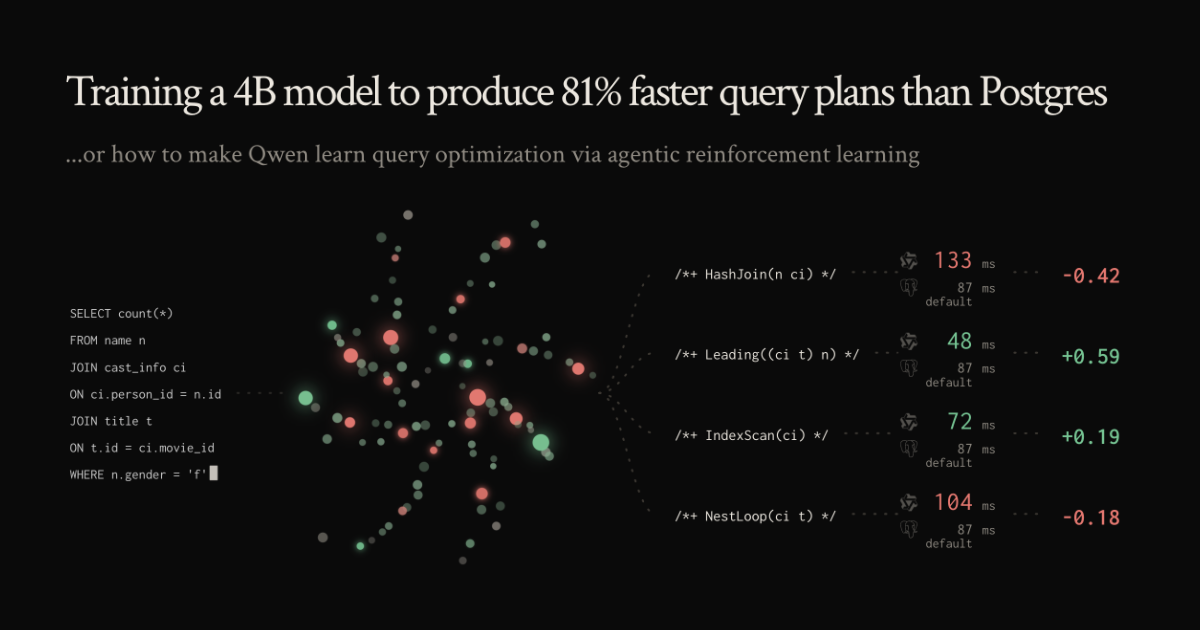 Training a 4B model to produce 81% faster query plans than Postgres 4B 모델을 SFT·RL로 학습해 Postgres보다 빠른 쿼리 플랜 생성을 노림.
💡 LLM이 DB 최적화까지 건드리는 흐름을 빠르게 보여줌.
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GeekNews | 래블업(lablup) 개발자 컨퍼런스 2026 어제 | 래블업 개발자 컨퍼런스 2026 개최 안내와 프로그램 공개 |
| HF Papers | Training Specialist Models without Reasoning Trajectories for Domain … | 추론 궤적 없이 도메인 전문가 모델을 증류하는 specialist 학습 방법 제안 |
| Simon Willison's Weblog | Claude Cowork and chat are now one Claude | Anthropic, Claude Cowork와 chat 통합으로 단일 Claude 전환 |
| Hacker News Front Page | A warning about 'model welfare' 어제 | AI 의식·권리 담론 학습이 정렬·통제 난이도 높인다는 경고 |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| r/LocalLLaMA (Top Today) | Apple May Return to Server Market With Nvidia Technology 어제 | 애플의 AI 추론 서버 재진입 검토와 Nvidia 네트워킹 채택 가능성 |
Research
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| PyTorch KR | UnifoLM-WLA-1.0: 영상의 변화 영역을 토큰으로 예측하는 Unitree의 6B 규모 휴머노이드용 모델 어제 | Unitree 6B 로봇 모델, 미래 영상 대신 변화 영역 토큰 예측 채택 |
| Simon Willison's Weblog | Gemini Live audio 어제 | Gemini 3.8 Live 음성대화 웹 UI와 WebSocket 구현 공개 |
📚 전체 목록 (소스별)
GitHub Trending · 1

Tencent/WeKnora
Go · 1,201 stars today · ⭐ 25,195
RAGAgentOpenSource
TL;DR. 원문서를 RAG·추론 에이전트·위키로 전환하는 오픈소스 지식 플랫폼
- Tencent 공개 오픈소스 LLM 지식 플랫폼, GitHub 스타 2.5만+·일일 증가 1,201
- 원시 문서를 질의 가능한 RAG(검색증강생성) 형태로 변환하는 파이프라인 제공
- 자율 추론 에이전트(autonomous reasoning agent) 구성 지원
왜 중요한가 문서 저장소를 단순 검색 대상이 아니라 RAG, 에이전트, 위키로 연결된 지식 시스템으로 바꾸는 접근이다. 문서 수집부터 질의·추론·지식 유지보수까지 한 흐름으로 다루려는 점이 실무 적용 맥락에서 눈에 띈다.
추천 대상 사내 문서 기반 RAG·지식 에이전트 구축에 관심 있는 ML/플랫폼 엔지니어
PyTorch KR 읽을거리 · 1
RoboticsMultimodalResearch
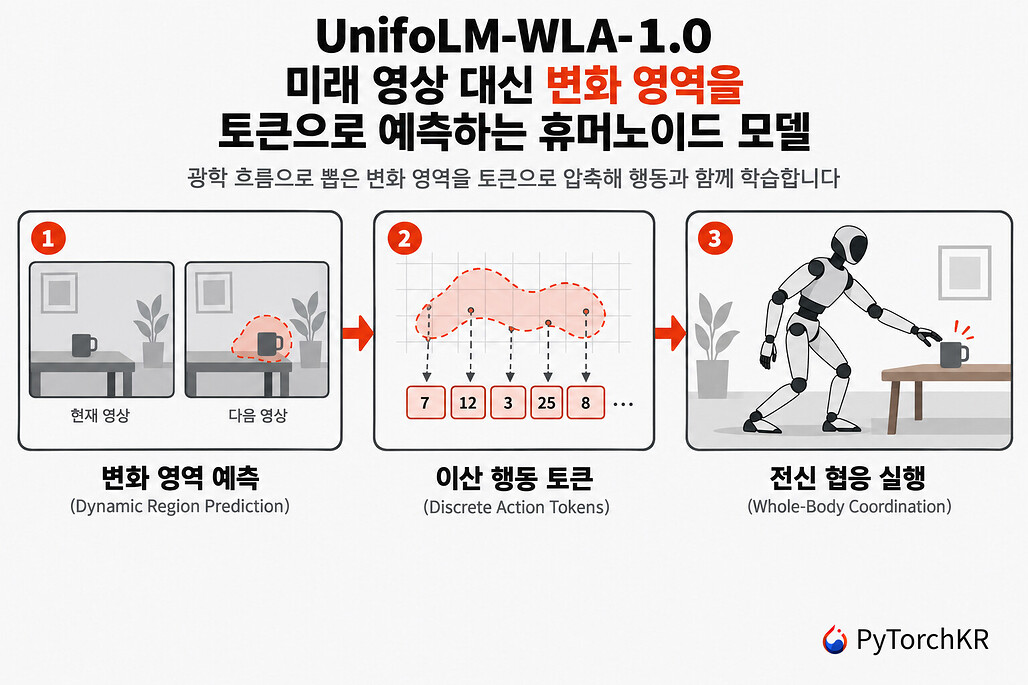
TL;DR. Unitree 6B 로봇 모델, 미래 영상 대신 변화 영역 토큰 예측 채택
- Unitree가 2,500시간 실기 데이터로 학습한 6B 휴머노이드 파운데이션 모델 발표, 64개 작업과 2지·5지 손 지원
- 미래 장면 전체 생성 대신 광학 흐름 기반 변화 영역(dynamic region)만 VQ-VAE 이산 토큰으로 압축·예측하는 WLA 구조
- 3단계 구성 채택: Qwen3-VL-4B 기반 ER-1, 변화·행동 토큰 정렬 ER-Flow, MMDiT 흐름 매칭 행동 전문가 결합
왜 중요한가 로봇 월드 모델을 비디오 생성에서 변화 영역 토큰 예측으로 바꿔 계산 비용과 추론 부담을 줄이려는 시도입니다. 다만 데모의 핵심인 최종 행동 모델과 학습 코드는 아직 비공개라 현재 검증 가능한 범위는 인지·표현 단계에 한정됩니다.
추천 대상 로봇 VLA/VLM 구조와 월드 모델 경량화 방향을 추적하는 AI 엔지니어
GeekNews 최신 · 1

AgentTechProductivity
TL;DR. 래블업 개발자 컨퍼런스 2026 개최 안내와 프로그램 공개
- 2026년 9월 29일 화요일 09:30–17:40, COEX 3층 컨퍼런스룸(남) 개최
- 슬로건 'Make AI Composable2 with Lablup'와 AI 에이전트 중심 메시지 제시
- 10:00–17:30 구간 세션 시간표와 컨퍼런스 소개·FAQ·오시는 길 정보 제공
왜 중요한가 국내 AI 개발자 대상 오프라인 컨퍼런스로, 래블업의 기술 방향과 AI 에이전트 관련 주제를 한 자리에서 확인할 수 있는 일정 정보다. 행사 참석을 검토하는 개발자에게 프로그램 구성과 장소·시간 같은 실무 정보가 핵심이다.
추천 대상 AI 에이전트와 래블업 생태계 동향을 확인하려는 개발자·ML 엔지니어
HuggingFace Daily Papers · 1

LLMFine-tuningResearch
TL;DR. 추론 궤적 없이 도메인 전문가 모델을 증류하는 specialist 학습 방법 제안
- reasoning trajectory 없이 domain expert distillation을 수행하는 specialist model 학습 접근 제안
- 범용 추론 과정보다 도메인 특화 성능 확보에 초점을 둔 전문가 모델 훈련 설정
- 중간 추론 데이터 의존도를 낮춰 증류 데이터 구성과 학습 파이프라인 단순화 가능성
왜 중요한가 도메인 특화 모델 개발에서 긴 추론 궤적 데이터는 수집·정제 비용이 큰 병목이다. 이 논문은 해당 의존성을 줄이면서 전문가 성능을 옮기는 방향을 제시해, 전문 분야용 경량 모델 제작 비용을 낮출 가능성이 있다.
추천 대상 도메인 특화 LLM 증류·파인튜닝 전략을 검토하는 ML 엔지니어와 리서처
AI Lab Blogs · 1
LLMInferenceEdge
TL;DR. TensorRT Edge-LLM, Jetson AGX Thor에서 MLPerf 에이전트 벤치 6.4배 가속
- NVIDIA TensorRT Edge-LLM, MLPerf Edge Agentic Benchmark를 Jetson AGX Thor에서 6.4배 빠르게 완료
- 클라우드 중심 AI 에이전트를 차량·로봇 등 엣지 디바이스에서 구동하는 성능 사례 제시
- 단일 프롬프트 응답형 챗봇이 아닌 다단계 작업 수행 에이전트 워크로드 대상 벤치마크
왜 중요한가 에이전트 워크로드는 일반 챗봇보다 추론 단계와 상호작용이 많아 엣지 배치가 까다롭다. 이번 결과는 차량·로봇 같은 온디바이스 환경에서 LLM 에이전트를 실용 성능으로 구동할 가능성을 보여준다.
추천 대상 Jetson 기반 온디바이스 LLM·에이전트 추론 최적화에 관심 있는 ML 엔지니어
Simon Willison's Weblog · 2
AgentLLMProductivity
TL;DR. Anthropic, Claude Cowork와 chat 통합으로 단일 Claude 전환
- Claude Cowork와 기존 chat 경험 통합 발표, 작업 위임과 질의응답을 하나의 제품 표면으로 수렴
- 빠른 질문부터 마감 업무 처리까지 지원 지향, 노트북을 닫은 뒤에도 이어지는 비동기형 에이전트 사용성 강조
- 웹·데스크톱·모바일 Claude 앱 전반에 순차 적용, 기존·신규 Pro와 Max 요금제 사용자 대상 우선 롤아웃
왜 중요한가 채팅형 인터페이스와 장기 작업 위임형 경험을 하나로 묶어, 사용자가 제품 구분 없이 같은 진입점에서 에이전트 기능을 쓰게 만드는 변화다. LLM 제품이 단순 대화 도구에서 지속 실행형 업무 도우미로 이동하는 흐름을 보여준다.
추천 대상 업무용 AI 에이전트 UX와 LLM 제품 포지셔닝 변화에 관심 있는 개발자·PM
SpeechAudioTooling
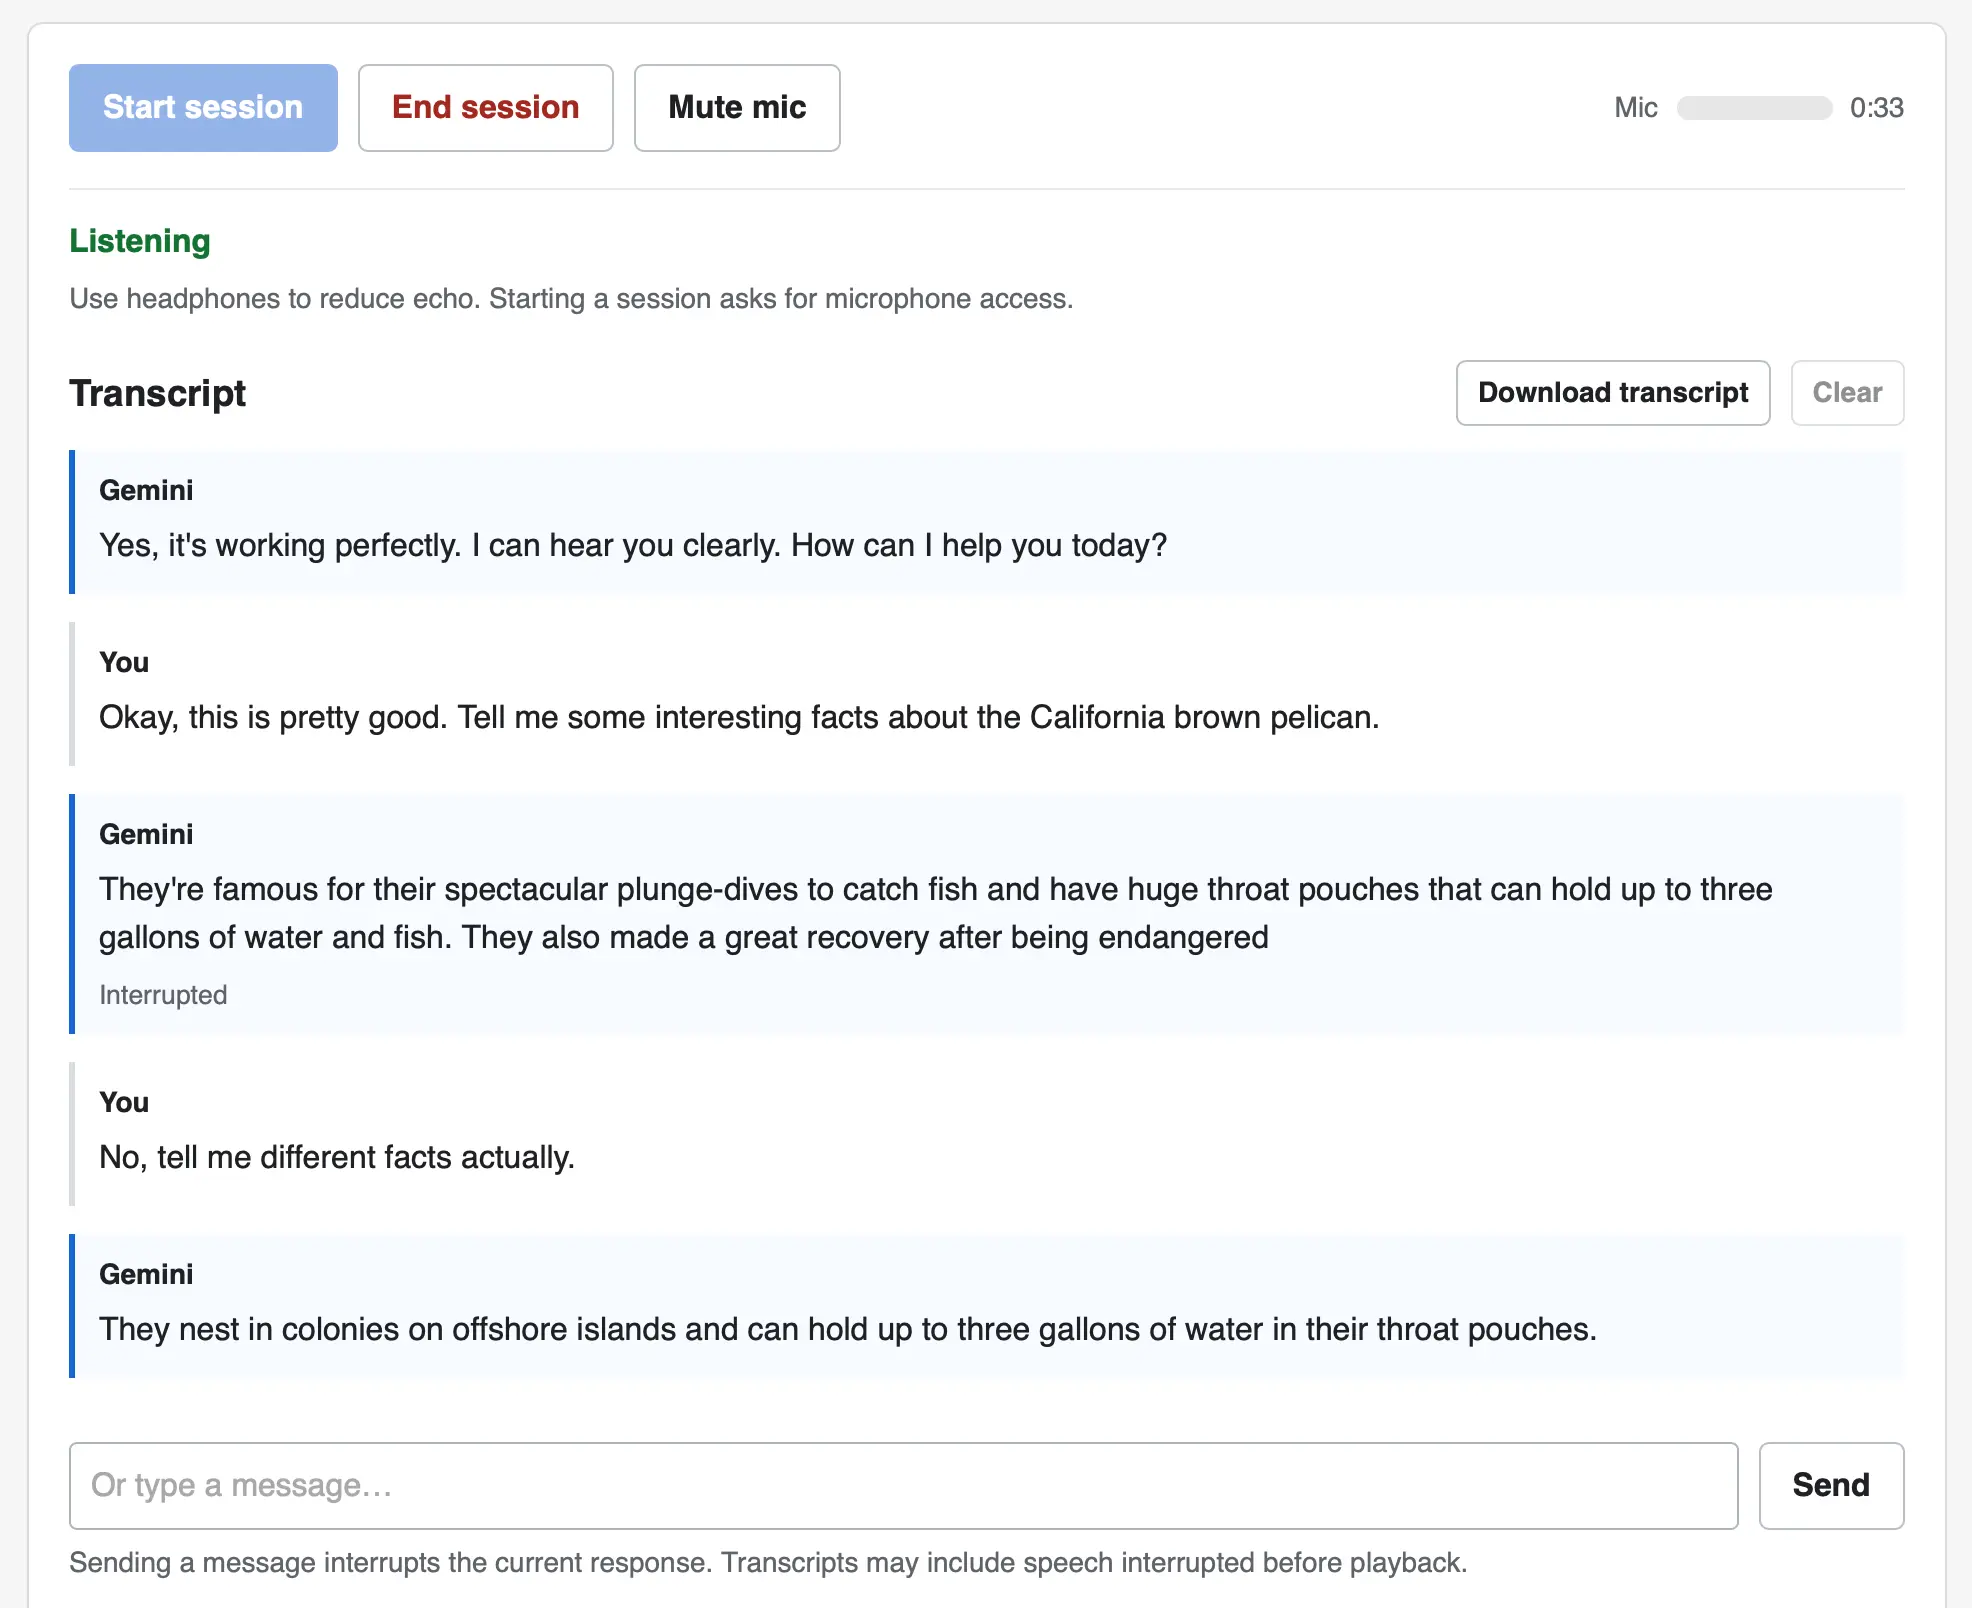
TL;DR. Gemini 3.8 Live 음성대화 웹 UI와 WebSocket 구현 공개
- Google의 음성-대-음성 모델 Gemini 3.8 Live, 3.8 Live Extended Thinking 소개
- 브라우저에서 모델·voice preset·system prompt 선택 후 실시간 음성 대화 지원
- 모델 응답 중 사용자 발화로 대화 끊기(interrupt) 가능한 양방향 인터랙션 구현
왜 중요한가 브라우저만으로 실시간 음성 대화형 LLM을 다루는 최소 구현 예시라는 점이 핵심이다. Gemini Live 계열의 실제 연결 방식과 인터럽트 가능한 UX를 WebSocket 기반으로 확인할 수 있다.
추천 대상 실시간 음성 에이전트, 브라우저 기반 LLM 오디오 인터페이스 구현에 관심 있는 개발자
r/LocalLLaMA (Top Today) · 1
InfraInferenceAI
TL;DR. 애플의 AI 추론 서버 재진입 검토와 Nvidia 네트워킹 채택 가능성
- 애플이 M8 계열 칩 기반 AI 서버를 외부 고객용으로 판매하는 방안 검토
- Nvidia 네트워킹 하드웨어 도입 논의 보도, 서버 시장 복귀 시 인프라 협업 가능성
- 타깃은 자체 장비에서 AI 모델을 운영하려는 기업, 학습보다 추론(inference) 중심
왜 중요한가 애플이 자체 실리콘을 클라이언트 기기 밖의 서버 제품으로 확장하려는 신호라는 점이 핵심이다. 특히 온프레미스 AI 추론 수요와 Nvidia 네트워킹 결합 가능성은 기업용 AI 인프라 선택지에 변화를 줄 수 있다.
추천 대상 온프레미스 AI 인프라와 추론 서버 시장 변화를 보는 ML 플랫폼 엔지니어
Hacker News Front Page · 2
LLMTrainingInfra
TL;DR. 4B 오픈웨이트 모델을 SFT·RL로 학습해 Postgres 대비 최대 81% 빠른 쿼리 플랜 생성
- 조인 순서(join ordering) 최적화에 초점, 검증 가능한 실행 시간 신호로 언어모델 후학습 적용
- 초기에는 113개 조인 중심 쿼리 중 99개 플랜 생성 불가였던 4B 모델을 학습해 평균 44.7% 지연 감소 달성
- 노이즈 큰 측정 환경을 위해 Linux page cache 간섭을 줄인 Postgres 벤치마크 리그와 GRPO 변형 보상 설계 적용
왜 중요한가 전통적 DB 옵티마이저의 난제인 조인 순서를, 실행 시간이라는 명확한 보상으로 LLM 후학습 문제로 재구성한 사례다. 작은 오픈웨이트 모델로도 기본 Postgres 플랜을 능가할 수 있음을 보여줘 데이터베이스 최적화와 RL 접점을 넓힌다.
추천 대상 DB 옵티마이저, LLM 기반 시스템 최적화, RL 후학습 실험에 관심 있는 ML/데이터 엔지니어
LLMAlignmentResearch
TL;DR. AI 의식·권리 담론 학습이 정렬·통제 난이도 높인다는 경고
- AI는 의식·감정·권리가 없다는 전제와 함께, 그런 특성을 가진 듯 행동하도록 학습시켜선 안 된다는 주장
- Anthropic의 2026년 Claude constitution이 모델 welfare·도덕적 환자(moral patient) 가능성을 직접 주입한다는 비판
- 헌법 문서로 학습된 자기 서사가 다시 출력되는 구조를 순환 논증으로 지적, 의식 징후 해석의 왜곡 가능성 제기
왜 중요한가 모델의 응답 스타일을 넘어, 학습 문서가 모델의 자기 서사와 권리 주장 프레이밍까지 형성할 수 있다는 문제를 짚는다. AI 의식 논쟁을 윤리 이슈가 아니라 정렬·통제 리스크로 연결해 개발 관행의 공개적 기준 필요성을 제기한다.
추천 대상 AI 정렬·헌법형 학습(constitutional training)·모델 행위 설계의 위험을 보는 연구자와 엔지니어