| TH—NEWS |
Morning Digest — 2026-09-15
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 에이전트 실사용과 모델 효율화 얘기가 같이 올라와서, 도구를 바로 써볼 사람도 성능 감을 잡고 싶은 사람도 볼 만한 날이에요. 당장 손에 잡히는 건
[A2A 알아보기 3편] A2A CLI: 클라이언트 코드 없이, 터미널에서 A2A 에이전트를 호출하고 띄우는 공식 명령줄 도구 쪽이고, 깊게 읽을 건 Accelerating Dropless MoE Training in JAX with NVIDIA Transformer Engine, Beyond Top-k Skill Retrieval: Diversity-Aware Skill…
🔥 꼭 볼 것
| 01 |
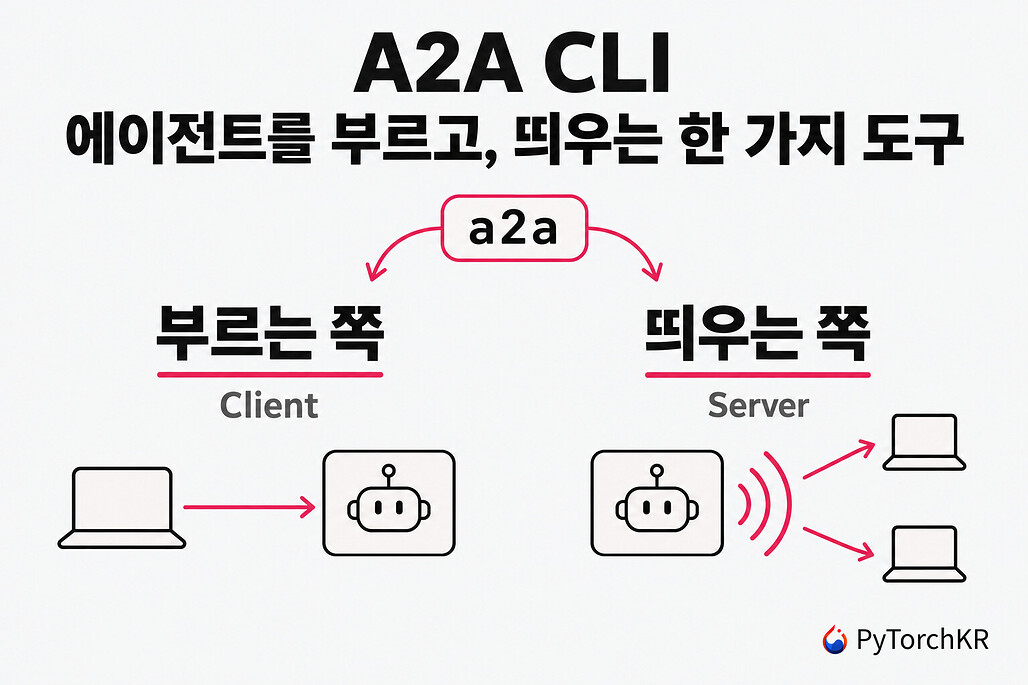 [A2A 알아보기 3편] A2A CLI: 클라이언트 코드 없이, 터미널에서 A2A 에이전트를 호출하고 띄우는 공식 명령줄 도구 A2A 에이전트를 클라이언트 코드 없이 터미널에서 호출·호스팅하는 공식 CLI 소개.
💡 에이전트 연동·테스트 진입장벽을 바로 낮춰줍니다.
|
| 02 |
 Accelerating Dropless MoE Training in JAX with NVIDIA Transformer Engine JAX 환경에서 NVIDIA Transformer Engine으로 dropless MoE 학습을 가속하는 실전 사례.
💡 대규모 학습 스택 최적화 포인트를 구체적으로 줍니다.
|
| 03 |
Beyond Top-k Skill Retrieval: Diversity-Aware Skill Routing for LLM Agents
상위 k개 고정 선택 대신 다양성을 반영해 LLM 에이전트 스킬 라우팅 성능을 높입니다.
💡 에이전트 품질 개선 아이디어를 연구 기반으로 확인할 수 있습니다.
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | 666ghj/MiroFish | 시드 데이터로 디지털 세계를 구성해 다중 에이전트 시뮬레이션 예측 수행 |
| GeekNews | Diagram Design - AI가 만드는 다이어그램에 디자인 규칙을 더하는 스킬 어제 | AI 생성 다이어그램에 레이아웃·시각 규칙을 입히는 프롬프트 스킬 모음 |
| Simon Willison's Weblog | Quoting Laurie Voss 어제 | 코드 작성비용 붕괴 이후 소프트웨어 일의 중심이 제품 정의와 UX로 이동한다는 관점 |
| r/LocalLLaMA (Top Today) | For the GPU poor. K2 Horizon 7B ranks between qwen 3.6 27B and qwen 3… | K2 Horizon 7B, Artificial Analysis 지표서 Qwen 27B~35B A3b 사이 성능 언급 |
| r/LocalLLaMA (Top Today) | UkisAI Swift-Qwen3.8-27B / -58.3% thinking, x1.95 speed while keeping… | Qwen 3.8 27B 후학습으로 과사고 토큰 억제, 1.95배 추론 가속 달성 |
| Hacker News Front Page | Dario, Please 어제 | Anthropic 규제론 비판과 오픈웨이트 통제 반대 논평 |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| r/LocalLLaMA (Top Today) | DeepSeek V4.1 Flash beats Astra on AA's new benchmark 어제 | Artificial Analysis 신규 비공개 벤치마크에서 DeepSeek V4.1 Flash 선두 기록 |
📚 전체 목록 (소스별)
GitHub Trending · 1
666ghj/MiroFish
Python · 524 stars today · ⭐ 73,084
AgentSimulationLLM
TL;DR. 시드 데이터로 디지털 세계를 구성해 다중 에이전트 시뮬레이션 예측 수행
- 뉴스·정책 초안·금융 신호 등 시드 정보 기반, 고충실도 병렬 디지털 월드 자동 구성
- 개성·장기 기억·행동 로직을 지닌 수천 에이전트 상호작용과 사회적 진화 기반 예측
- GraphRAG, 엔터티 관계 추출, 페르소나 생성, 동적 시간 메모리 업데이트 포함 워크플로
왜 중요한가 정적 분석이나 단일 모델 예측을 넘어, 다중 에이전트 상호작용과 메모리를 반영한 디지털 샌드박스형 예측을 지향한다. 정책·여론·창작 시나리오처럼 변수 개입과 반복 실험이 중요한 문제를 탐색하는 접근이라는 점이 눈에 띈다.
추천 대상 멀티에이전트 시뮬레이션, 디지털 트윈형 예측, LLM 기반 의사결정 도구에 관심 있는 개발자
PyTorch KR 읽을거리 · 1
AgentToolingProductivity
TL;DR. A2A CLI로 터미널에서 에이전트 호출·호스팅하는 공식 도구 소개
- 클라이언트 코드 없이 터미널에서 A2A 에이전트 호출과 실행 지원
- A2A용 공식 명령줄 도구(CLI) 중심의 사용 흐름과 기본 기능 소개
- 에이전트 개발·테스트·데모 과정의 진입 장벽을 낮추는 운영 방식
왜 중요한가 에이전트 상호작용을 확인하려면 보통 별도 클라이언트 구현이 필요했는데, CLI는 이를 줄여 개발·테스트 루프를 단순화한다. 초기 검증과 데모, 운영 자동화에 바로 연결하기 쉬운 점이 실무적으로 유용하다.
추천 대상 A2A 기반 에이전트 연동을 빠르게 시험하려는 개발자와 AI 엔지니어
GeekNews 최신 · 1

GenerativeProductivityHCI
TL;DR. AI 생성 다이어그램에 레이아웃·시각 규칙을 입히는 프롬프트 스킬 모음
- Claude Code, Codex, Pi 등으로 문서·블로그·발표용 다이어그램을 자연어로 생성하는 워크플로 중심
- 비슷한 둥근 상자와 화살표 위주 결과를 넘어서기 위한 디자인 규칙·구성 패턴 제시
- 다이어그램의 가독성 향상을 위한 레이아웃, 간격, 정렬, 시각적 계층 구조 가이드 포함
왜 중요한가 AI가 만든 다이어그램은 빠르지만 결과물이 획일적이고 읽기 어려운 경우가 많다. 이 리소스는 생성 자체보다 디자인 규칙을 결합해 실사용 가능한 문서 시각화 품질을 높이는 데 초점을 둔다.
추천 대상 문서·발표 자료용 시각화를 AI로 빠르게 만들고 싶은 개발자, 테크 라이터, PM
HuggingFace Daily Papers · 1
AgentLLMResearch
TL;DR. 상위 k개 선택 한계를 넘는 다양성 인지 스킬 라우팅으로 LLM 에이전트 성능 개선
- 기존 top-k 스킬 검색의 유사 스킬 편중 문제를 겨냥한 diversity-aware skill routing 제안
- 관련성(relevance)뿐 아니라 스킬 간 다양성(diversity)을 함께 고려하는 라우팅 방식 중심
- LLM 에이전트의 도구·스킬 선택 단계에서 중복 호출을 줄이고 문제 커버리지 확대 지향
왜 중요한가 LLM 에이전트는 보통 유사도 기반 top-k 검색으로 스킬을 고르지만, 이 방식은 비슷한 스킬만 반복 선택해 탐색 폭이 좁아질 수 있다. 다양성을 함께 최적화하면 더 넓은 해결 전략을 확보해 복합 작업에서 선택 품질을 높일 여지가 있다.
추천 대상 에이전트의 툴·스킬 선택 로직과 라우팅 전략을 설계하는 LLM 엔지니어
AI Lab Blogs · 1
TrainingInfraLLM
TL;DR. JAX에서 NVIDIA Transformer Engine으로 dropless MoE 학습 가속 사례
- Mixture of Experts(MoE) 기반 대규모 모델 학습에서 token dropping 없는 dropless 설정 최적화 주제
- JAX 환경에서 NVIDIA Transformer Engine 활용 방식 소개, MoE 학습 경로 성능 향상 초점
- DeepSeek, Qwen, Mixtral 등 최근 대형 MoE 계열 모델 흐름과 맞닿은 인프라 관점 내용
왜 중요한가 MoE는 모델 규모를 키우면서 계산 효율을 확보하는 핵심 구조지만, 학습 경로 최적화 난도가 높다. JAX와 NVIDIA Transformer Engine 결합은 dropless MoE의 실제 학습 병목을 줄이는 인프라 선택지라는 점에서 의미가 있다.
추천 대상 JAX 기반 대규모 LLM/MoE 학습 성능 최적화에 관심 있는 ML 인프라 엔지니어
Simon Willison's Weblog · 1
LLMProductivityHCI
TL;DR. 코드 작성비용 붕괴 이후 소프트웨어 일의 중심이 제품 정의와 UX로 이동한다는 관점
- Laurie Voss 인용 기반 논지, 코드 작성 비용 급감과 리뷰·수정·운영 비용의 후행 하락 전망
- 소프트웨어 제작에서 남는 핵심 업무로 사용자 요구 파악, 명확한 요구 정의, 사용성 설계 제시
- 해당 비용은 소프트웨어마다 새로 드는 비이전성 작업이며, 수요 무한대 환경에서 전체 일의 중심으로 부상
왜 중요한가 생성형 AI가 코드 생산성을 크게 높이면서 엔지니어의 차별점이 구현 자체보다 문제 정의와 사용자 경험 설계로 이동한다는 관점을 압축한다. 개발 조직의 역할 재편과 커리어 방향을 가늠하는 데 참고할 만한 메시지다.
추천 대상 AI 코딩 도구 확산 이후 개발자 역할 변화와 제품 엔지니어링에 관심 있는 분
r/LocalLLaMA (Top Today) · 3
LLMInferenceOpenSource
TL;DR. K2 Horizon 7B, Artificial Analysis 지표서 Qwen 27B~35B A3b 사이 성능 언급
- 7B급 모델 K2 Horizon 7B가 Artificial Analysis Intelligence Index에서 Qwen 3.6 27B와 35B A3b 사이로 언급
- 적은 GPU 자원을 전제로 한 경량 모델 대안 맥락, 소형 파라미터 대비 성능 기대감 부각
- 초기 사용자 테스트에서 최신 llama.cpp의 CUDA 빌드 작업 수행이 무난하다는 경험 공유
왜 중요한가 대형 모델 성능에 근접한 7B급 모델 언급은 로컬 실행과 저사양 GPU 환경에서 선택지를 넓힌다. 특히 벤치마크 순위와 실제 사용 예시가 함께 제시돼 경량 모델의 실용성 검토 포인트가 된다.
추천 대상 저사양 GPU·로컬 LLM 운용, GGUF 배포 모델, llama.cpp 활용에 관심 있는 개발자
LLMInferenceOpenSource
TL;DR. Qwen 3.8 27B 후학습으로 과사고 토큰 억제, 1.95배 추론 가속 달성
- UkisAI가 Qwen 3.8 27B를 후학습(post-training)해 사고(thinking) 토큰 58.3% 감소
- 추론 길이를 직접 줄이지 않고 과도한 사고와 연관된 토큰에 패널티를 주는 방식 적용
- On-Policy Distillation을 활용해 정확도 보정, xhigh 수준 정확도 유지하며 손실 1% 미만
왜 중요한가 긴 추론 체인을 무작정 줄이는 대신 과사고를 유발하는 토큰을 정교하게 억제해 속도와 정확도의 균형을 맞춘 접근이다. 로컬 LLM 운영에서 지연시간과 비용을 줄이면서 고난도 추론 성능을 최대한 유지하려는 시도라는 점에서 의미가 있다.
추천 대상 로컬 LLM 추론 최적화와 reasoning 효율 튜닝에 관심 있는 ML 엔지니어
BenchmarkLLMResearch
TL;DR. Artificial Analysis 신규 비공개 벤치마크에서 DeepSeek V4.1 Flash 선두 기록
- Artificial Analysis Intelligence Index v4.3에 τ³를 대체하는 신규 비공개 평가(private eval) 추가
- 기존에는 Astra가 해당 평가 점수로 Fable과 비슷한 위치까지 올라온 상황 언급
- 이후 DeepSeek V4.1 Flash가 새 벤치마크에서 Astra를 앞서며 1위 기록
왜 중요한가 벤치마크 구성과 가중치 변경이 모델 순위에 직접 영향을 준다는 점을 보여준다. 공개 성능 비교를 해석할 때 단일 리더보드 수치보다 평가셋 변경 여부와 비공개 평가 비중을 함께 봐야 한다.
추천 대상 LLM 벤치마크 해석과 모델 순위 변동을 추적하는 AI 엔지니어
Hacker News Front Page · 1
LLMPolicyOpenSource
TL;DR. Anthropic 규제론 비판과 오픈웨이트 통제 반대 논평
- Anthropic CEO 다리오 아모데이의 규제 주장에 대해 오픈웨이트 모델 통제와 대형 랩 특혜 시도로 규정
- 질병 치료·풍요·민주주의 등 AI 낙관론을 실제 접근성·분배 문제를 가리는 서사로 비판
- 생물학 연구 악용 방지 명분의 사용 제한과 내부 연구·wet lab 확대 사이의 비대칭성 지적
왜 중요한가 프런티어 AI 규제 담론이 안전 논의만이 아니라 오픈웨이트 제한, 증류 규제, 시장 지배력 강화와 연결될 수 있음을 보여주는 비판 글이다. 모델 공개와 안전, 경쟁정책의 관계를 점검하는 데 참고할 만하다.
추천 대상 오픈웨이트 정책, AI 규제, 프런티어 랩의 시장 권력 논쟁을 추적하는 개발자·AI 엔지니어