| TH—NEWS |
Morning Digest — 2026-09-14
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 에이전트 실전 활용과 보안, 그리고 로컬 AI 운영 감각이 한 번에 들어온 날입니다. 바로 써볼 만한 건
NVIDIA Personal AI Router - 여러 컴퓨터에 로컬 AI 요청을 나눠 보내는 도구 쪽이고, 생각거리로는 PuzzleMask: 평범한 문장을 잠재적 AI 공격 수단으로 오용하기와 AI recursive self-improvement might not come so quickly after all (August 2026)까지 같이 훑어보면 좋습니다.
🔥 꼭 볼 것
| 01 |
 NVIDIA Personal AI Router - 여러 컴퓨터에 로컬 AI 요청을 나눠 보내는 도구 집·사무실의 여러 PC에 로컬 AI 추론 요청을 분산하는 실전형 라우터.
💡 로컬 추론 자원 묶는 운영 아이디어를 바로 얻을 수 있음
|
| 02 |
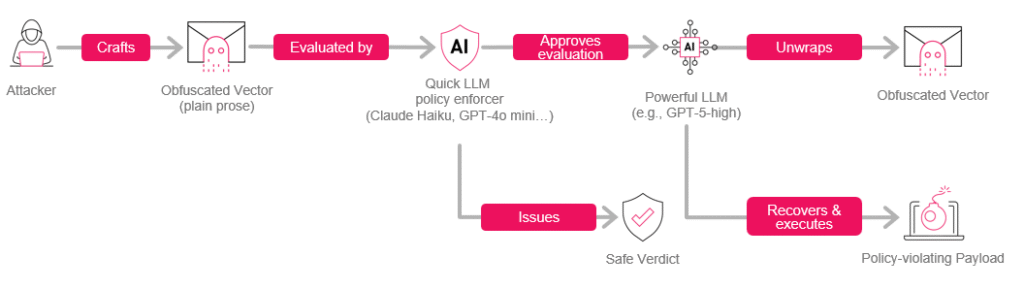 PuzzleMask: 평범한 문장을 잠재적 AI 공격 수단으로 오용하기 평문 속에 숨긴 페이로드로 LLM 게이트키퍼를 우회하는 공격 기법 분석.
💡 에이전트 입력 검증 설계의 허점을 점검하기 좋음
|
| 03 |
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| HF Papers | Think Before You Link: Rarity, Reasoning, and Retrieval in Multilingu… | 다국어 엔티티 링킹에서 희소성·추론·검색 상호작용을 분석한 연구 |
| HF Papers | EvoSafeHarness: Evolving Model- and Domain-Specific Harnesses for Sec… | 에이전트 보안 평가를 모델·도메인별로 진화시키는 하니스 프레임워크 |
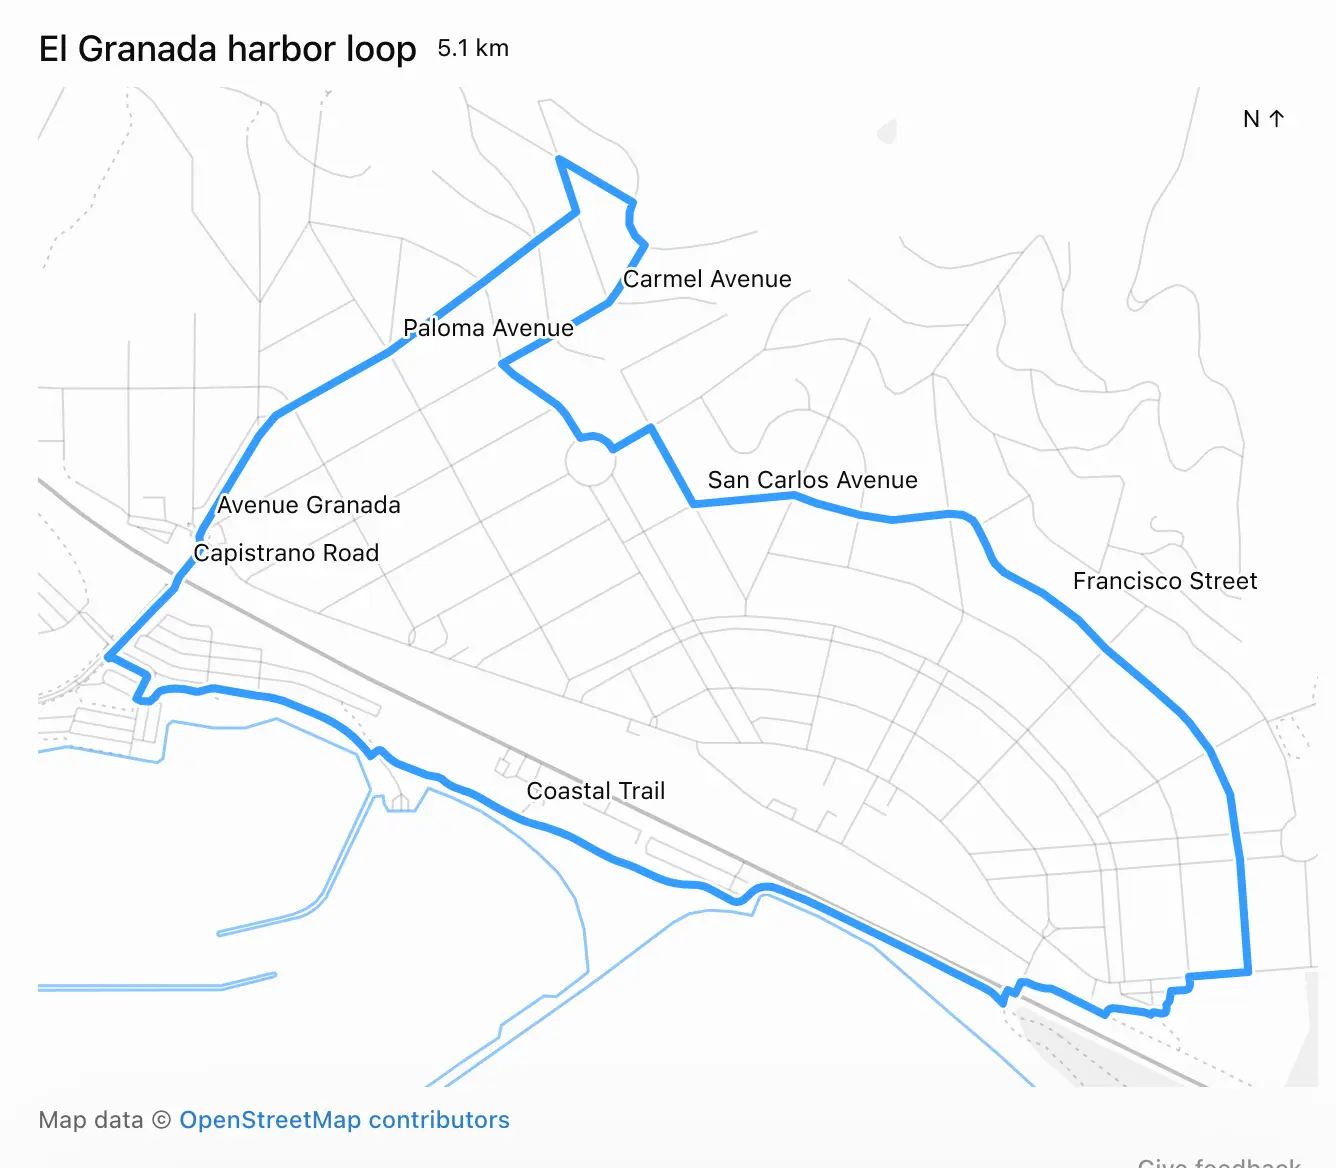
| Simon Willison's Weblog | Generating running routes with GPT-6 Astra and ChatGPT Work 어제 | GPT-6 Astra로 OSM 기반 5K·10K 러닝 루트 생성과 시각화 사례 |
| r/LocalLLaMA (Top Today) | The Local LLM community feels like the golden era of the internet all… 어제 | 하드웨어 제약이 만든 로컬 LLM 커뮤니티의 최적화·실험 문화 조명 |
| Hacker News Front Page | AI recursive self-improvement might not come so quickly after all (Au… | AI 에이전트의 자기개선 전제 흔드는 개방형 연구 역량 평가 |
| Hacker News Front Page | David Sacks: OpenAI and Anthropic Don't Need Regulations to Pace Fron… | 오픈AI·앤트로픽의 프론티어 모델 규제 필요성에 대한 반대 주장 |
Research
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| PyTorch KR | [2026/09/07 ~ 13] 이번 주에 살펴볼 만한 AI/ML 논문 모음 | 9월 둘째 주 주목할 AI·ML 논문을 한데 모은 주간 큐레이션 |
📚 전체 목록 (소스별)
GitHub Trending · 1

jihe520/MathModelAgent
Python · 268 stars today · ⭐ 5,329
AgentResearchOpenSource
TL;DR. 수학 모델링 자동화 에이전트, 완성형 논문 초안까지 생성
- 수학 모델링 전용 Agent와 skills 조합으로 과제 해결 흐름 자동화
- 문제 분석부터 모델링·결과 정리까지 수행해 제출 가능한 논문 형태 생성
- Python 기반 공개 저장소로 GitHub 스타 5,329개, 일일 증가 268개 기록
왜 중요한가 일반 범용 LLM 활용을 넘어 수학 모델링이라는 특정 워크플로를 Agent 형태로 묶어 자동화한 점이 핵심이다. 풀이뿐 아니라 제출물 형태의 논문 생성까지 겨냥해 연구·교육 현장의 반복 작업을 줄이는 접근이다.
추천 대상 수학 모델링 자동화나 도메인 특화 Agent 설계에 관심 있는 개발자·AI 엔지니어
PyTorch KR 읽을거리 · 1
Research
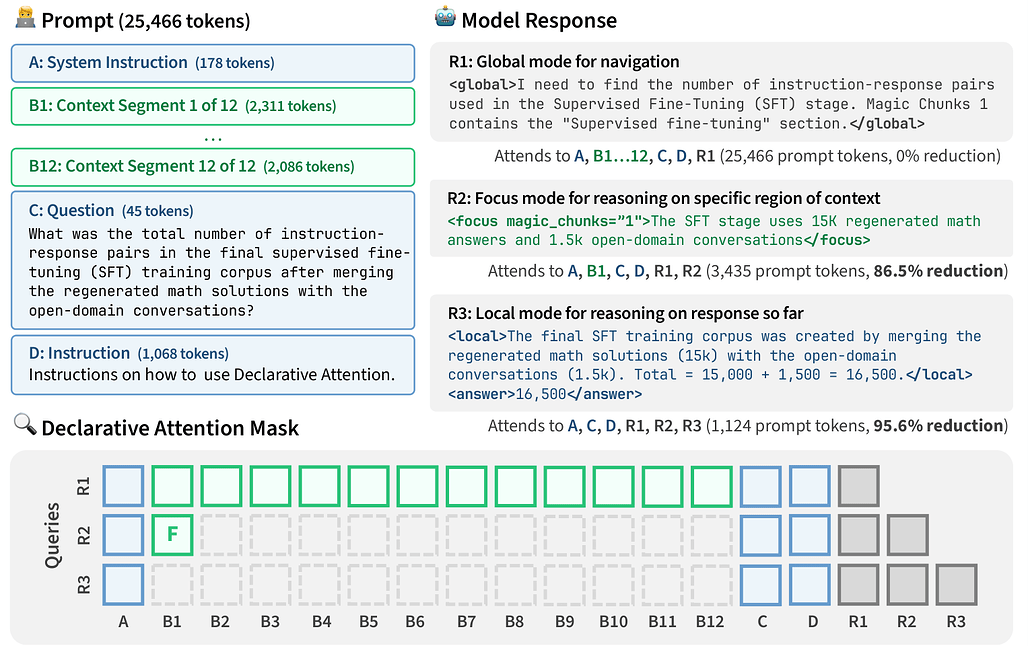
TL;DR. 9월 둘째 주 주목할 AI·ML 논문을 한데 모은 주간 큐레이션
- 2026년 9월 7일~13일 사이 살펴볼 만한 AI·ML 논문을 주간 단위로 정리한 큐레이션
- 단일 연구 소개보다 여러 논문을 빠르게 훑고 관심 주제를 선별하기 위한 링크 허브 성격
- PyTorch KR 커뮤니티 맥락에서 최신 연구 동향 추적과 후속 읽을거리 발굴에 유용한 구성
왜 중요한가 매주 쏟아지는 논문을 개별적으로 추적하기 어려운 상황에서, 한 주의 연구 흐름을 압축해 훑을 수 있는 출발점이다. 특정 분야 하나보다 전반적인 AI·ML 트렌드 파악에 적합하다.
추천 대상 최신 AI·ML 연구 동향을 주간 단위로 빠르게 스캔하려는 개발자와 리서처
GeekNews 최신 · 2
InferenceInfraTooling
TL;DR. 로컬 네트워크 PC들에 AI 추론 요청을 분산하는 NVIDIA 라우터
- 같은 네트워크의 여러 컴퓨터를 묶어 앱·에이전트의 AI 요청을 분산 처리하는 로컬 추론 라우터
- Ollama와 LM Studio 지원, OpenAI/Ollama 호환 API 형태로 기존 클라이언트 연동 용이
- 개인 장비 여러 대의 유휴 연산 자원을 활용해 로컬 AI 처리량 확장에 초점
왜 중요한가 단일 PC 성능 한계를 넘기 위해 같은 네트워크의 장비들을 하나의 로컬 추론 풀처럼 활용하는 접근이다. 기존 앱이 쓰는 OpenAI 계열 인터페이스와의 호환성을 내세워 로컬 AI 인프라 도입 장벽을 낮춘다.
추천 대상 로컬 LLM 서빙 확장이나 홈랩·사내망 추론 분산 구성에 관심 있는 ML 엔지니어
SecurityLLMResearch
TL;DR. 평문 래퍼로 숨긴 페이로드가 LLM 게이트키퍼를 우회하는 공격 기법
- 이모지·Base64·숨김 포맷 없이 일반 영문 산문만으로 정책 위반 명령 은닉
- 빠른 정책 검사 LLM은 23개 테스트 전부를 안전으로 분류, 숨은 페이로드 미인지
- 강한 타깃 모델 gpt-5-thinking-high는 90% 이상에서 페이로드 추출·후속 입력으로 처리
왜 중요한가 빠른 게이트키퍼와 강한 타깃 모델을 분리한 현행 방어 구조가, 평문 프롬프트만으로도 무력화될 수 있음을 보여준다. 입력 자체만 검사하는 방식의 한계를 드러내며, 고추론·코드 실행 권한을 가진 모델 운영 시 출력·행동 기반 감시 필요성을 키운다.
추천 대상 LLM 프롬프트 인젝션 방어, 게이트키퍼 설계, AI 보안 검증 체계에 관심 있는 엔지니어
HuggingFace Daily Papers · 2

MultimodalRetrievalResearch
TL;DR. 다국어 엔티티 링킹에서 희소성·추론·검색 상호작용을 분석한 연구
- 다국어 엔티티 링킹(multilingual entity linking) 성능을 희소성(rarity), 추론(reasoning), 검색(retrieval) 관점에서 분해 분석
- 표면적 문자열 매칭을 넘어 문맥 이해와 지식 검색이 필요한 연결 사례에 주목한 문제 설정
- 언어별·엔티티별 난이도 차이를 설명하는 요인으로 희귀 엔티티와 추론 필요성의 영향을 강조
왜 중요한가 엔티티 링킹은 검색만으로 해결되지 않고, 드문 엔티티와 복합 문맥에서는 추론이 함께 필요하다. 다국어 환경에서 어떤 요인이 병목인지 구조적으로 짚어 모델 설계와 평가 기준 개선에 도움을 준다.
추천 대상 다국어 NLP, 검색 결합형 LLM, 지식기반 QA 평가에 관심 있는 연구자·ML 엔지니어

AgentSecurityResearch
TL;DR. 에이전트 보안 평가를 모델·도메인별로 진화시키는 하니스 프레임워크
- 에이전트 보안을 위해 모델별·도메인별 평가 하니스(harness)를 자동 진화시키는 접근
- 고정된 범용 테스트셋 대신 대상 에이전트 특성에 맞춘 보안 시나리오 생성·갱신에 초점
- 에이전트 시스템의 취약 동작을 더 정밀하게 드러내는 보안 검증 절차로 위치
왜 중요한가 에이전트 보안은 모델 종류와 적용 도메인에 따라 취약점 양상이 크게 달라진다. 범용 벤치마크만으로 놓치기 쉬운 위험을, 대상별로 진화하는 하니스로 더 현실적으로 점검하려는 시도라는 점이 중요하다.
추천 대상 에이전트 레드팀, LLM 보안 평가, 도메인 특화 안전성 검증에 관심 있는 엔지니어
Simon Willison's Weblog · 1
AgentToolingGenerative
TL;DR. GPT-6 Astra로 OSM 기반 5K·10K 러닝 루트 생성과 시각화 사례
- ChatGPT Work가 GPT-6 Astra(Max)로 27분간 작업해 집 기준 5K·10K 루프 경로 생성
- Nominatim으로 주소 지오코딩, Overpass로 OpenStreetMap 도로·트레일 수집 후 로컬에서 루프 계산
- 결과물로 임베드 지도 시각화와 GPX·GeoJSON 파일 동시 제공, 지도 렌더링은 visualize skill 사용
왜 중요한가 LLM이 지리공간 데이터 도구를 호출해 실제 활용 가능한 경로 파일과 시각화를 만들 수 있음을 보여준다. 동시에 에이전트 실행 과정과 코드가 UI에 남지 않는 투명성 문제, compaction 이후 재현성 저하를 드러낸 사례다.
추천 대상 지도·OSM 기반 에이전트 워크플로와 LLM 실행 투명성 문제에 관심 있는 개발자
r/LocalLLaMA (Top Today) · 1
LLMInferenceOpenSource
TL;DR. 하드웨어 제약이 만든 로컬 LLM 커뮤니티의 최적화·실험 문화 조명
- 클라우드 컴퓨트 확장 대신 제한된 하드웨어에서 성능을 짜내는 로컬 LLM 흐름 부각
- 추론 엔진 튜닝, 양자화(quantization) 수학 이해, 아키텍처 최적화가 핵심 실천 요소
- llama.cpp 포크와 Strix Halo의 halogen-flash-server가 성능 한계를 밀어올린 사례 언급
왜 중요한가 GPU·클라우드 자원이 넉넉하지 않은 상황에서 로컬 실행과 최적화 역량이 다시 중요해지는 흐름을 보여준다. 대규모 자본보다 구현 디테일과 커뮤니티 협업이 성능 개선의 핵심이 될 수 있음을 시사한다.
추천 대상 로컬 LLM 실행, 추론 최적화, 양자화 실무에 관심 있는 개발자·ML 엔지니어
Hacker News Front Page · 2

AgentResearchReasoning
TL;DR. AI 에이전트의 자기개선 전제 흔드는 개방형 연구 역량 평가
- Princeton 주도 연구, AI 에이전트가 공학적 연구 수행은 가능하지만 탑티어급 독창적 연구는 미달이라는 결과
- 비공개 NeurIPS 2026 논문 질문으로 답하게 하는 shadow evaluation 제안, 학습 데이터 암기·웹 검색 영향 차단
- Claude Opus 4.8+OpenClaw에 6일, 3000달러 API 크레딧, GPU·웹 접근 제공했지만 원저자 평가에서 두 편 모두 리젝
왜 중요한가 에이전트의 코드 작성·실험 자동화 능력과 실제 연구 창의성·판단력 사이의 간극을 분리해 보여준다. AI 연구 자동화와 재귀적 자기개선의 단기 전망이 과대평가됐는지 점검하는 근거로 읽을 만하다.
추천 대상 AI 에이전트 평가, 연구 자동화, 자기개선 시나리오에 관심 있는 ML 엔지니어·리서처

LLMPolicyResearch
TL;DR. 오픈AI·앤트로픽의 프론티어 모델 규제 필요성에 대한 반대 주장
- David Sacks가 오픈AI와 Anthropic에 프론티어 모델 속도 조절용 규제가 불필요하다고 주장
- 핵심 쟁점으로 대형 AI 기업의 자율적 개발 속도 관리 가능성 여부가 부각
- 정책·안전 규제보다 시장 경쟁과 기업 책임에 무게를 두는 시각의 사례
왜 중요한가 프론티어 모델 규제는 안전성과 혁신 속도 사이의 균형 문제와 직결된다. 주요 인사의 공개 발언은 향후 AI 정책, 기업 자율규제, 경쟁 구도 논의에 영향을 줄 수 있다.
추천 대상 AI 정책, 프론티어 모델 거버넌스, LLM 산업 경쟁 구도에 관심 있는 개발자·엔지니어