| TH—NEWS |
Morning Digest — 2026-09-11
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 에이전트가 확실한 중심이고, 실제로 써볼 만한 API·IDE·코딩 성능 업데이트가 많아서 바쁜 날에도 훑어볼 가치가 있어요. 깊게 읽을 건
Introducing the Agents API, Proliferate - 여러 코딩 에이전트를 병렬로 실행하는 오픈소스 AI IDE, Cognition's SWE-2 achieves 92.8 on Terminal-Bench 2.1 쪽이고, 나머지는 벤치마크나 응용 연구를 가볍게 체크해도 흐름 파악은 됩니다.
🔥 꼭 볼 것
| 01 | |
| 02 |
 Proliferate - 여러 코딩 에이전트를 병렬로 실행하는 오픈소스 AI IDE 여러 코딩 에이전트를 병렬 실행·통합 관리하는 오픈소스 AI IDE
💡 개발 워크플로 실험용으로 바로 써볼 만합니다
|
| 03 |
 Cognition's SWE-2 achieves 92.8 on Terminal-Bench 2.1 코딩 에이전트 SWE-2가 Terminal-Bench 2.1에서 92.8을 기록
💡 에이전트 성능 상한선 체감에 유용합니다
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| HF Papers | SWE-Bench Pro Verified: A Reliable Benchmark for Software Engineering… | 소프트웨어 엔지니어링 에이전트 평가 신뢰성을 높인 검증형 벤치마크 제안 |
| Simon Willison's Weblog | .blend URL Viewer 어제 | 브라우저에서 .blend 파일을 바로 보는 URL 뷰어 공개 |
| r/LocalLLaMA (Top Today) | DeepSeek V4.1 Flash: Stronger, Faster, More Accessible 어제 | DeepSeek V4.1 Flash 공개, 소형 멀티모달 구조로 성능·속도·처리량 강화 |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | JustVugg/colibri | VRAM·RAM·디스크를 단일 계층으로 묶어 초대형 MoE 추론을 노리는 순수 C 엔진 |
| HF Papers | WearableQA: A Benchmark for Health Reasoning over Real-World Wearable… | 실사용 웨어러블 데이터 기반 건강 추론 벤치마크 WearableQA 제안 |
Research
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| PyTorch KR | WeatherNext 3: 위성 관측을 직접 읽어 매시간 갱신하는 5km 해상도 기상 예보 AI (feat. Google D… 어제 | 위성 관측 직입력과 매시간 초기화로 5km급 전 지구 예보를 구현한 WeatherNext 3 |
| HF Papers | Show-Harness: Just a VLM Agent Can Play Robots | VLM 에이전트 단독으로 로봇 조작을 수행하는 Show-Harness 제안 |
📚 전체 목록 (소스별)
GitHub Trending · 1

JustVugg/colibri
C · 130 stars today · ⭐ 27,415
InferenceInfraOpenSource
TL;DR. VRAM·RAM·디스크를 단일 계층으로 묶어 초대형 MoE 추론을 노리는 순수 C 엔진
- 순수 C·엔진 의존성 0 구조로 744B~2.8T급 MoE 모델을 소비자·이기종 하드웨어에서 실행 지향
- VRAM·RAM·NVMe를 단일 추론 계층으로 다루는 AI memory multitiering 기반, 저장장치 용량 제약을 속도 문제로 환원
- GLM-5.2/5.3, Kimi K3, DeepSeek V4 Flash, Qwen 계열, OLMoE 등 8개 모델 패밀리 지원
왜 중요한가 대형 MoE 추론을 고가의 대규모 GPU 클러스터 전용 문제로 보지 않고, 저장장치까지 포함한 계층형 메모리와 I/O 최적화로 접근한 점이 핵심이다. 모델 의미를 바꾸지 않는다는 제약 아래 실제 종단간 측정으로 정책을 검증하는 연구·실행 플랫폼 성격도 뚜렷하다.
추천 대상 대형 LLM/MoE 서빙 최적화, 이기종 메모리 계층, 로컬 추론 인프라에 관심 있는 ML 시스템 엔지니어
PyTorch KR 읽을거리 · 1
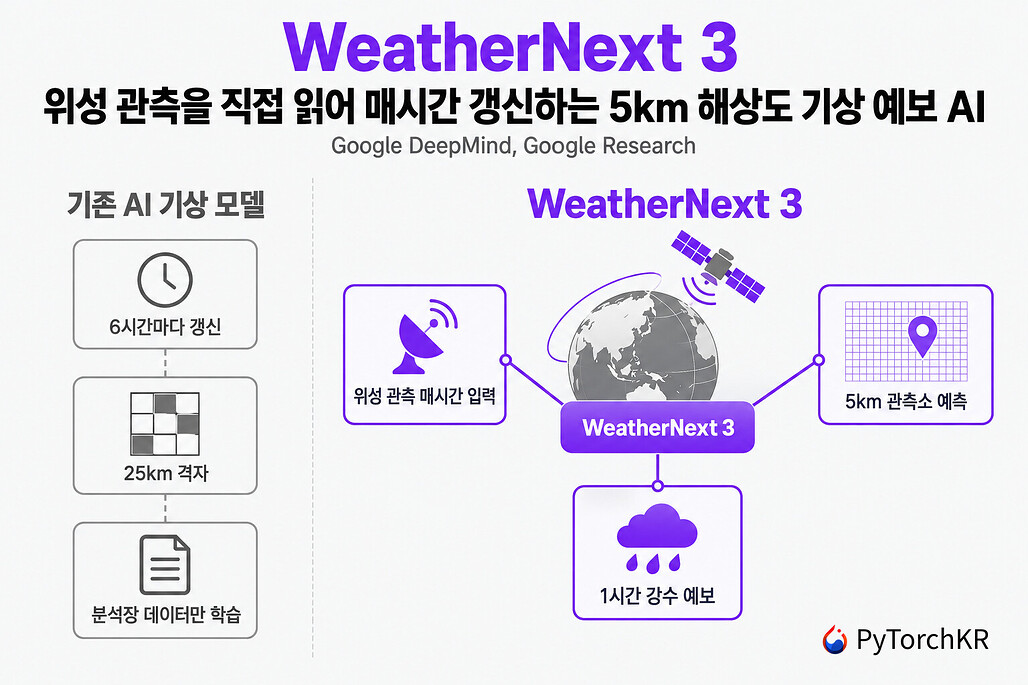
ResearchWeatherMultimodal
TL;DR. 위성 관측 직입력과 매시간 초기화로 5km급 전 지구 예보를 구현한 WeatherNext 3
- Google DeepMind·Google Research 공개 모델로 정지궤도 위성 모자이크와 관측소 데이터를 직접 학습하는 전 지구 기상 예보 AI
- 기존 6시간·25km급 AI 예보 대비 매시간 갱신, 5km 관측소 헤드와 10km 격자 출력으로 시간 6배·공간 약 5배 고해상도화
- 자료동화·예보·후처리를 단일 FGN 메시 트랜스포머로 통합하고 64개 멤버 확률 앙상블을 한 번의 순전파로 생성
왜 중요한가 기존 AI 기상 모델의 낮은 해상도와 분석장 의존 문제를 위성 원시 관측 직입력으로 줄인 점이 핵심입니다. 실시간성, 고해상도, 확률 예보를 동시에 끌어올려 운영형 AI 예보의 적용 범위를 넓힙니다.
추천 대상 기상 AI, 시계열 예측, 멀티해상도 생성 모델 설계에 관심 있는 ML 엔지니어
GeekNews 최신 · 1
CodingAgentOpenSource
TL;DR. 여러 코딩 에이전트를 병렬 실행·통합 관리하는 오픈소스 AI IDE
- Claude Code, Codex, OpenCode, Cursor, Grok 등 복수 코딩 에이전트 동시 활용 구조
- 에이전트별로 서로 다른 작업을 분담하고 진행 상황을 한곳에서 확인하는 데스크톱 IDE
- 작업마다 별도 컨텍스트를 유지해 병렬 실행 중 코드 변경 사항을 통합 추적하는 방식
왜 중요한가 단일 AI 코딩 도구에 작업을 몰아주는 방식 대신 여러 에이전트에 병렬로 역할을 나눠 생산성을 높이려는 접근이다. 분산된 진행 상태와 코드 변경을 한 UI에서 관리해 멀티 에이전트 협업의 운영 부담을 줄인다.
추천 대상 여러 AI 코딩 도구를 함께 쓰며 병렬 개발 워크플로를 구성하려는 개발자
HuggingFace Daily Papers · 3

VisionAgentRobotics
TL;DR. VLM 에이전트 단독으로 로봇 조작을 수행하는 Show-Harness 제안
- 비전언어모델(VLM) 에이전트만으로 로봇 작업 수행을 목표로 한 Show-Harness 소개
- 로봇 제어를 위한 별도 정책 모델 없이 VLM 기반 에이전트 활용 관점 제시
- 언어·시각 이해를 행동 실행으로 연결하는 로봇 플레이(play robots) 방향성 제안
왜 중요한가 로봇 조작에서 전용 정책 모델 대신 범용 VLM 에이전트를 전면에 두려는 접근으로 보인다. 시각 이해와 언어 지시를 하나의 에이전트로 묶어 로봇 작업 파이프라인을 단순화할 가능성이 있다.
추천 대상 VLM 기반 embodied agent와 로보틱스 제어 통합에 관심 있는 연구자·엔지니어

BenchmarkHealthResearch
TL;DR. 실사용 웨어러블 데이터 기반 건강 추론 벤치마크 WearableQA 제안
- 실세계 웨어러블 데이터 위 건강 관련 질문응답·추론 성능 평가용 벤치마크 제안
- 심박수 등 시계열 신호와 건강 맥락을 연결하는 모델의 이해·추론 능력 측정 초점
- 정형 QA를 넘어 실제 사용 환경의 데이터 특성과 건강 reasoning 과제 반영
왜 중요한가 LLM·멀티모달 모델이 건강 데이터를 다루려면 텍스트뿐 아니라 실제 웨어러블 시계열 신호 해석과 맥락 추론이 필요하다. WearableQA는 이 간극을 측정할 평가 축을 제시한다.
추천 대상 디지털 헬스, 웨어러블 데이터 분석, 의료 AI 벤치마크에 관심 있는 연구자·엔지니어

AgentBenchmarkCoding
TL;DR. 소프트웨어 엔지니어링 에이전트 평가 신뢰성을 높인 검증형 벤치마크 제안
- SWE-Bench Pro Verified 제안, 소프트웨어 엔지니어링 에이전트 평가용 신뢰도 강화 벤치마크
- 기존 SWE-Bench 계열의 평가 불확실성과 검증 한계 보완에 초점
- Verified 설정을 통해 문제 인스턴스와 정답 판정의 신뢰성 향상 지향
왜 중요한가 코드 수정·이슈 해결형 에이전트는 벤치마크 품질에 따라 성능 해석이 크게 달라진다. 검증된 평가 셋은 모델 간 비교의 잡음을 줄이고, 실제 개선이 무엇인지 더 명확히 드러내는 기반이 된다.
추천 대상 코딩 에이전트 평가셋과 SWE-Bench 계열 벤치마크 품질에 관심 있는 ML 엔지니어
AI Lab Blogs · 1
AgentAPITooling
TL;DR. Codex 기반 오케스트레이션·툴 사용을 제공하는 관리형 클라우드 Agents API 공개
- OpenAI의 관리형 서비스 형태 에이전트 API 출시, 클라우드 에이전트 빌드·배포 지원
- Codex harness 기반 오케스트레이션 제공, 에이전트 실행 흐름 관리 기능 강조
- 장시간 실행(long-running sessions) 지원, 단발 호출을 넘는 지속형 작업 처리 지향
왜 중요한가 에이전트 구현에 필요한 세션 유지, 오케스트레이션, 툴 호출을 관리형 API로 묶어 직접 인프라를 구성하는 부담을 낮추는 접근이다. 단순 LLM 호출을 넘어 장시간 실행형 에이전트 서비스 개발 수요와 맞닿아 있다.
추천 대상 에이전트 백엔드와 툴 호출 워크플로우를 빠르게 제품에 붙이려는 개발자
Simon Willison's Weblog · 1
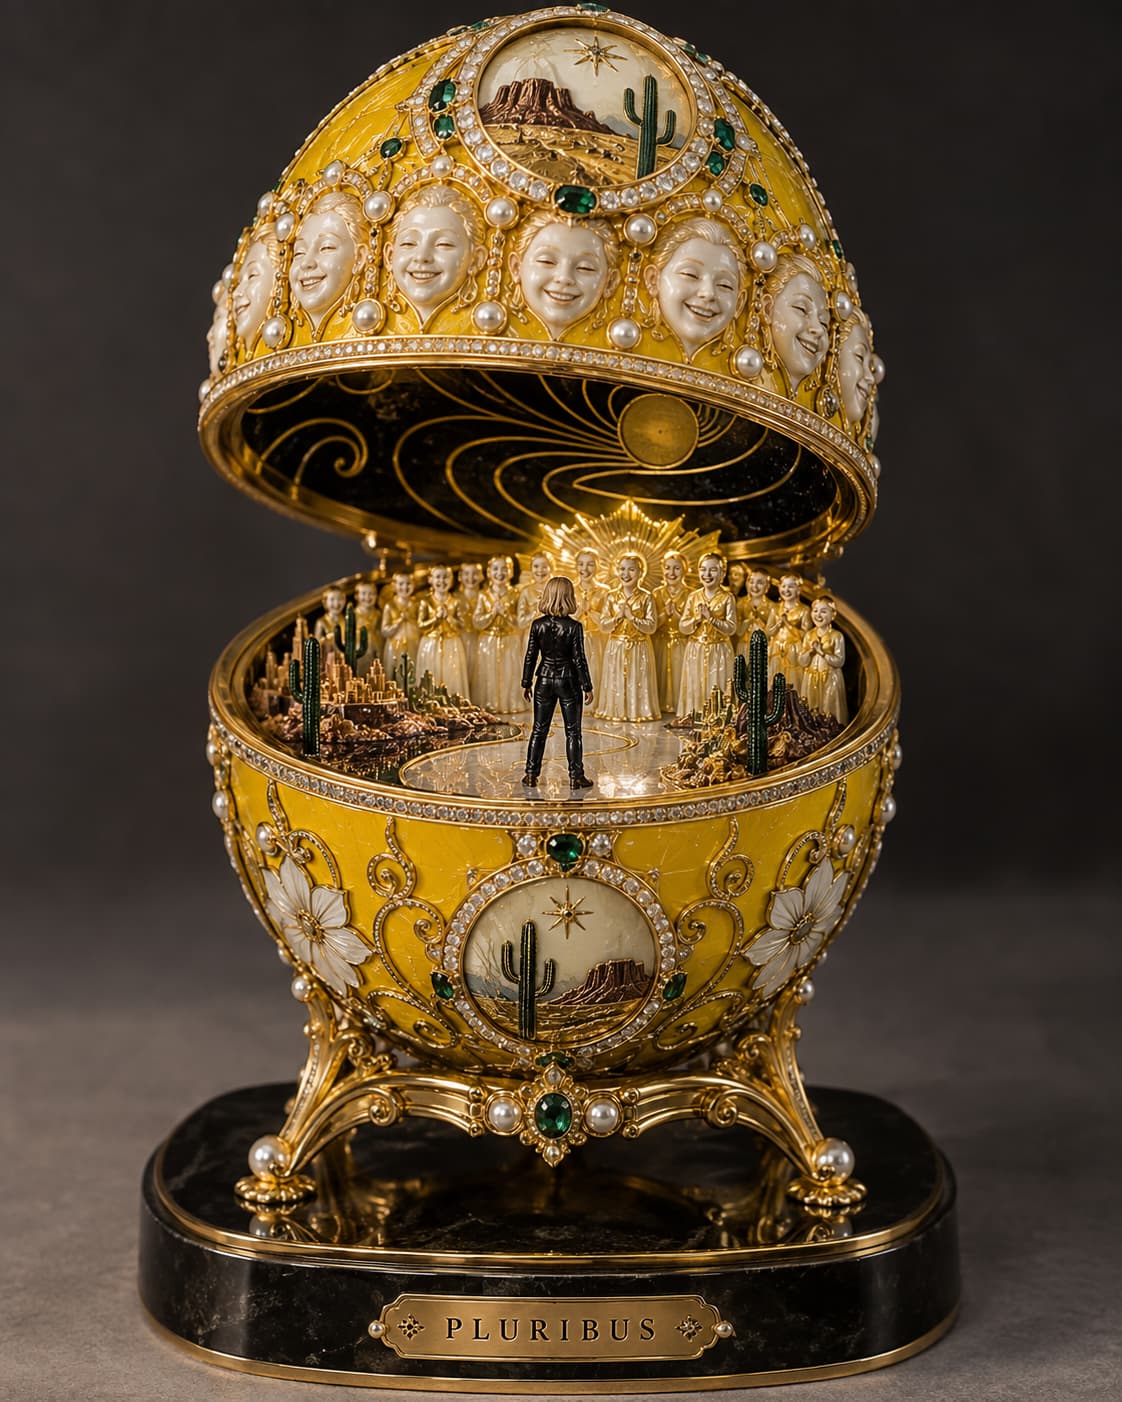
GenerativeToolingCoding
TL;DR. 브라우저에서 .blend 파일을 바로 보는 URL 뷰어 공개
- ChatGPT Images 2.5로 생성한 파베르제 달걀 이미지를 바탕으로 Blender 모델 제작 실험
- Codex의 GPT-6 Astra(high)와 blender local skill 조합으로 17분 51초 동안 여러 .blend 파일 생성
- 기존에 만들던 Blender 뷰잉 실험을 도구화해 .blend URL을 브라우저에서 확인하는 뷰어로 공개
왜 중요한가 이미지 생성 모델과 코딩 에이전트를 연결해 3D 자산을 만들고 즉시 웹에서 확인하는 흐름을 보여준다. .blend 파일 확인 진입장벽을 낮춰 AI 기반 3D 프로토타이핑과 공유 실험에 유용하다.
추천 대상 Blender 자동화, 코딩 에이전트, AI 기반 3D 프로토타이핑에 관심 있는 개발자
r/LocalLLaMA (Top Today) · 1
LLMMultimodalInference
TL;DR. DeepSeek V4.1 Flash 공개, 소형 멀티모달 구조로 성능·속도·처리량 강화
- DeepSeek V4.1 Flash 출시, 신규 아키텍처 계열의 최소 모델 포지션
- 네이티브 멀티모달 시각 이해 지원, 텍스트 중심 모델 대비 입력 범위 확장
- 더 높은 성능 상한, 더 빠른 추론, 더 높은 처리량 목표의 구조 설계
왜 중요한가 소형 모델에서 멀티모달 이해와 추론 속도·처리량을 함께 겨냥한 점이 핵심이다. 단순 경량화보다 새로운 아키텍처 계열의 출발점이라는 점에서, 이후 대형 모델 확장과 실사용 배치 방향을 가늠하게 한다.
추천 대상 멀티모달 LLM 아키텍처와 저지연 추론 최적화에 관심 있는 ML 엔지니어
Hacker News Front Page · 1
AgentCodingInference
TL;DR. Cognition SWE-2, Terminal-Bench 2.1 92.8 기록한 코딩 에이전트 모델
- Kimi K3 기반 2.8T 파라미터 MoE, 토큰당 104B 활성화, Cognition 후속 post-training 적용
- 멀티트릴리언 규모 RL 적용으로 대부분 벤치마크에서 기존 베이스 대비 5~6점 향상 주장
- FrontierCode 50.0, DeepSWE 73.0, Terminal-Bench 2.1 92.8, Terminal-Bench 4.0 27.3의 자체 보고 성능
왜 중요한가 코딩 에이전트 성능을 높이면서도 추론 비용과 상호작용 턴 수를 함께 낮춘 사례다. 다만 장기 과제 성격의 Terminal-Bench 4.0 격차와 비공개 가중치, 자체 보고 수치라는 한계가 함께 드러난다.
추천 대상 코딩 에이전트 성능·비용 지표와 LLM 서빙 최적화에 관심 있는 ML 엔지니어