| TH—NEWS |
Morning Digest — 2026-09-10
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 에이전트 운영·코딩 워크플로우 개선과 모델 서빙 최적화처럼 바로 손에 잡히는 실무감 있는 글이 많아요. 깊게 볼 건
Tencent/teamai-cli, Meta, Muse Spark 1.3 출시: 1M 컨텍스트 검색 55.5점에서 98.1점으로, 코딩 도구 호출 20% 절감, When to Use Encode-Prefill-Decode Disaggregation to Accelerate Multimodal Model Serving 정도고, 나머지는 신기한 실험과 업계 논란을 가볍게 훑어도 충분합니다.
🔥 꼭 볼 것
| 01 | |
| 02 |
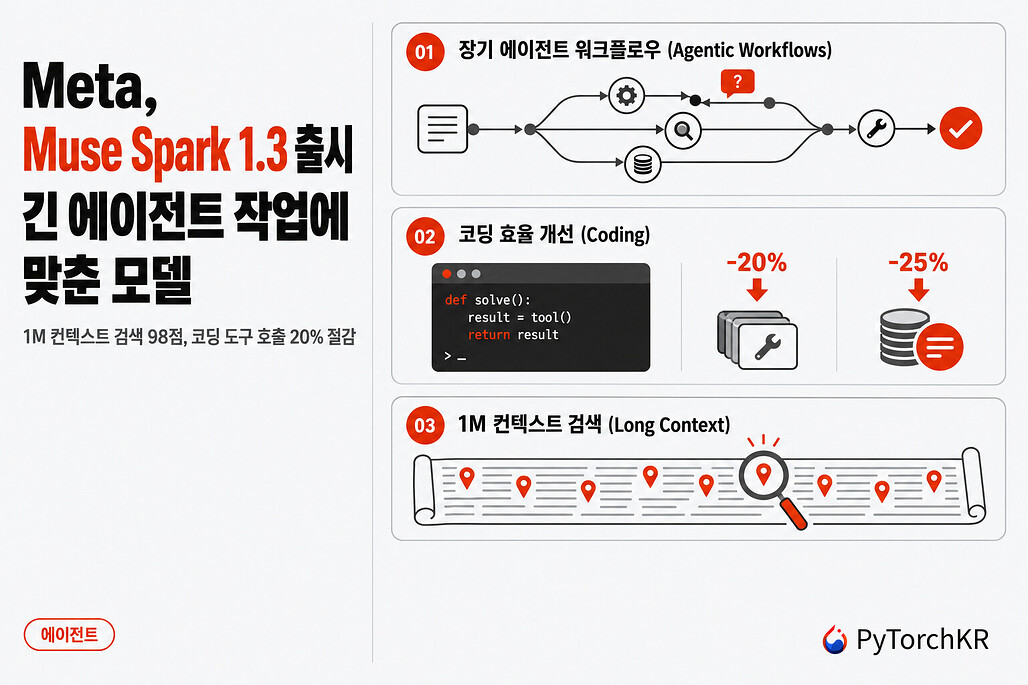 Meta, Muse Spark 1.3 출시: 1M 컨텍스트 검색 55.5점에서 98.1점으로, 코딩 도구 호출 20% 절감 롱컨텍스트 검색 성능과 에이전트 협업, 코딩 효율을 함께 끌어올린 업데이트.
💡 실사용 LLM 성능·비용 판단에 직접 영향 줌
|
| 03 |
 When to Use Encode-Prefill-Decode Disaggregation to Accelerate Multimodal Model Serving 멀티모달 모델 서빙에서 EPD 분리를 언제 적용해야 이득인지 기준을 정리한 글.
💡 서빙 병목과 GPU 효율 튜닝에 바로 참고 가능
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| HF Papers | NeoHorse-1: Towards Recursive Self-Improvement via Agentic Post-Train… | 라우팅 하네스 기반 에이전트형 사후학습으로 재귀적 자기개선 탐색 |
| Simon Willison's Weblog | On the Navier–Stokes Millennium Prize Problem 어제 | OpenAI의 나비에-스토크스 풀이 주장과 학습데이터 윤리 논란 |
| r/LocalLLaMA (Top Today) | Qwen 3.8 27b with PI agent - pushed to its 3D graphic game limits 어제 | Qwen 3.8 27B와 PI agent로 3D 게임 생성 한계 실험 |
| Hacker News Front Page | Qwen 3.8 follows GPT-5.5 Pro reasoning prefills | Qwen 3.8의 GPT-5.5 Pro 추론 프리필 모사 사례와 프롬프트 기법 정리 |
| Hacker News Front Page | Show HN: Self-hosted company OS, Claude Code and Codex agents in depa… | Claude Code·Codex 에이전트를 부서 단위로 묶는 셀프호스티드 회사 운영 OS |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| PyTorch KR | VDN-H3: MiniMax H3 영상을 재생 시간보다 빠르게 생성하는 하이브리드 어텐션 모델 (단, H3 모델은 한국 사용… 어제 | VDN-H3, 하이브리드 어텐션으로 MiniMax H3 영상 생성 지연 대폭 단축 |
| GeekNews | 내 PC가 AI 데이터센터가 된다: 유휴 컴퓨팅 자원의 새로운 수익화 어제 | 가정용 유휴 GPU를 AI 추론 인프라로 묶는 분산 수익화 모델 부상 |
📚 전체 목록 (소스별)
GitHub Trending · 1
Tencent/teamai-cli
TypeScript · 563 stars today · ⭐ 2,905
AgentToolingOpenSource
TL;DR. 여러 AI 코딩 에이전트에 팀 규칙·지식을 배포하는 CLI
- Claude Code, Codex, Cursor, CodeBuddy 등 다수 에이전트에 skills·rules·MCP·docs 동기화 지원
- 공유 Git 저장소를 중심으로 push→리뷰·머지→pull 흐름 구성, 세션 시작 시 최신 설정 자동 반영
- roles·tags·source 기능으로 역할별 리소스 구독과 타 팀 공개 저장소 재사용 지원
왜 중요한가 개별 개발자 로컬 프롬프트와 설정에 흩어진 팀 운영 지식을 Git 기반 워크플로로 표준화하는 접근이다. 여러 AI 코딩 에이전트에 동일한 규칙과 맥락을 배포해 팀 단위 재현성과 온보딩 효율을 높이는 데 유용하다.
추천 대상 사내 AI 코딩 에이전트 운영 표준화와 팀 지식 공유 자동화에 관심 있는 개발팀
PyTorch KR 읽을거리 · 2
VideoInferenceResearch
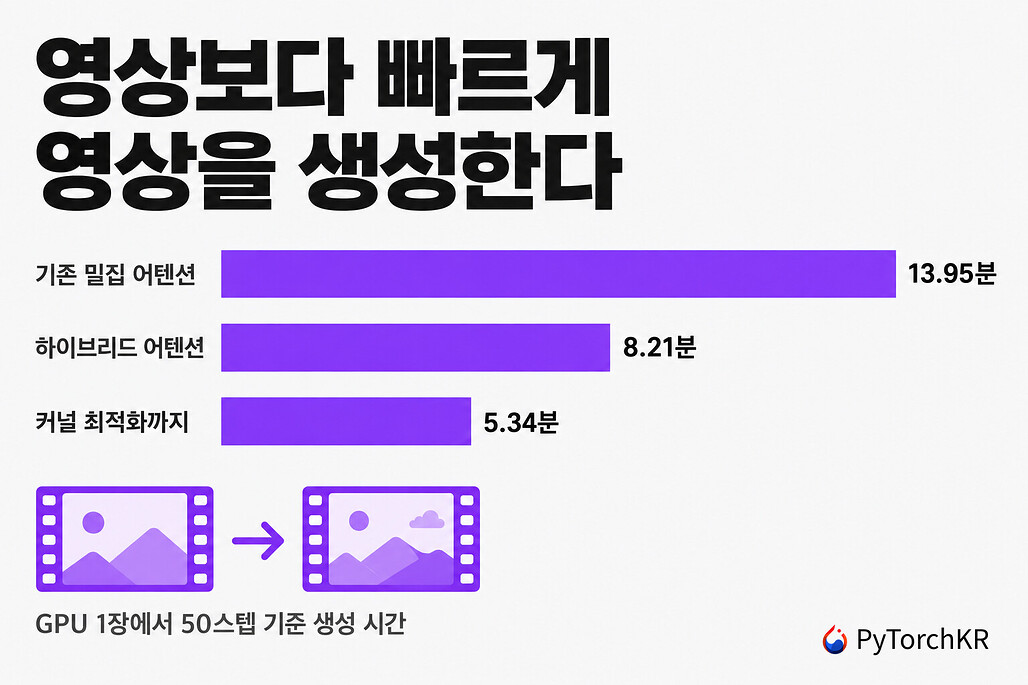
TL;DR. VDN-H3, 하이브리드 어텐션으로 MiniMax H3 영상 생성 지연 대폭 단축
- 소프트맥스 어텐션이 실행 시간 85% 이상 차지하는 병목을 근거리 소프트맥스+원거리 선형 어텐션으로 분리한 구조
- MiniMax H3 백본 이식판으로 8×NVIDIA B200, 8스텝 디노이징 기준 14.4초 영상을 11.23초에 생성
- 단일 GPU에서 NFE당 16.74초→6.41초, 8 GPU 분산 시 1.40초로 감소; 50스텝 기준 13.95분→5.3분
왜 중요한가 영상 생성은 긴 시퀀스 탓에 어텐션 비용이 특히 커서 지연이 제품성의 핵심 제약이 됩니다. VDN-H3는 전역 일관성 손실이 잦던 선형 어텐션의 약점을 하이브리드 구조로 보완하며, 추론 스택과 학습 코드까지 함께 공개한 점이 실무·연구 모두에서 의미 있습니다.
추천 대상 영상 생성 서빙 지연 최적화나 하이브리드 어텐션 구조 연구에 관심 있는 ML 엔지니어
AgentLLMCoding
TL;DR. Meta Muse Spark 1.3, 1M 롱컨텍스트·에이전트 협업·코딩 효율 동시 강화
- 100만 토큰 컨텍스트 검색 성능이 55.5점에서 98.1점으로 상승, 장문 스레드 맥락 연결 정확도 개선
- 코딩 작업에서 도구 호출 약 20%, 토큰 약 25% 절감, 같은 과제의 비용·지연 감소 가능성 제시
- 모호한 지시 되묻기, 위험 행동 전 확인, 불가 작업 명시 등 실사용 에이전트 상호작용을 학습 대상으로 반영
왜 중요한가 이번 릴리스는 최고 점수 경쟁보다 장시간 실행 에이전트의 실제 문제였던 모호한 지시 처리, 확인 절차, 자기 한계 인식에 초점을 맞춘 점이 다릅니다. 롱컨텍스트 성능과 코딩 효율을 함께 끌어올려 에이전트 운영 비용과 실패 위험을 동시에 낮추려는 방향이 보입니다.
추천 대상 코딩 에이전트 운영 최적화와 장기 실행 LLM 워크플로우에 관심 있는 ML·AI 엔지니어
GeekNews 최신 · 1

InferenceInfraMLOps
TL;DR. 가정용 유휴 GPU를 AI 추론 인프라로 묶는 분산 수익화 모델 부상
- AI 추론 수요 확대에 따라 가정용 서버·게이밍 PC·노트북의 유휴 자원 임대 모델 등장
- 중앙집중형 데이터센터 대신 분산형 인프라로 추론 워크로드를 처리하는 구조 부각
- 기존에 놀던 개인용 컴퓨팅 자원을 수익화 가능한 공급 자원으로 전환하는 접근
왜 중요한가 AI 추론 수요가 급증하는 상황에서 데이터센터 증설만으로 대응하기 어려운 비용·공급 제약을 완화할 수 있는 접근이다. 유휴 개인 기기를 인프라 자원으로 편입해 분산 처리와 자원 효율 개선 가능성을 보여준다.
추천 대상 LLM 추론 인프라, 분산 컴퓨팅, GPU 자원 시장에 관심 있는 ML 엔지니어
HuggingFace Daily Papers · 1

AgentLLMResearch
TL;DR. 라우팅 하네스 기반 에이전트형 사후학습으로 재귀적 자기개선 탐색
- NeoHorse-1이 제안하는 recursive self-improvement 목표의 agentic post-training 프레임
- Routing Harness를 통한 문제 분기·도구 선택·에이전트 실행 구조 제시
- 단일 모델 성능 향상보다 반복적 개선 루프 설계에 초점의 접근
왜 중요한가 기존 사후학습이 단일 모델의 정답률 향상에 집중했다면, 이 작업은 라우팅과 에이전트 실행을 묶어 자기개선 루프 자체를 학습 대상으로 본다는 점이 다릅니다. 에이전트 시스템이 스스로 성능을 끌어올리는 구조 설계에 관심 있는 흐름과 맞닿아 있습니다.
추천 대상 에이전트형 LLM 학습, post-training, 자기개선 루프 설계에 관심 있는 ML 엔지니어
AI Lab Blogs · 1
MultimodalInferenceInfra
TL;DR. 멀티모달 서빙에서 EPD 분리 적용 시점과 성능 최적화 조건 정리
- 비전 인코더, prefill, decode 단계를 분리하는 EPD(disaggregation) 기반 멀티모달 추론 최적화 기법 소개
- 비전 인코더 단계와 LLM 추론 단계를 분리해 자원 경합을 줄이고 서빙 처리량·지연시간 개선 방향 제시
- 모든 워크로드에 일괄 적용하는 방식이 아니라 모델 구조·입력 특성·병목 위치에 따른 적용 기준 설명
왜 중요한가 멀티모달 모델은 비전 인코딩과 LLM 추론의 계산 특성이 달라 단일 파이프라인에서 비효율이 생기기 쉽다. EPD 분리는 이런 병목을 단계별로 나눠 다루며, 어떤 조건에서 실제 이점이 나는지 판단 기준을 제공한다.
추천 대상 멀티모달 LLM 서빙 최적화와 GPU 자원 배치에 관심 있는 ML 인프라 엔지니어
Simon Willison's Weblog · 1
LLMTrainingResearch
TL;DR. OpenAI의 나비에-스토크스 풀이 주장과 학습데이터 윤리 논란
- OpenAI, 미공개 모델로 나비에-스토크스 존재성과 매끄러움 문제 해결 주장
- 에이전트 88시간 동안 전체 난제 평가 수행, 490만 메시지·3000억 출력 토큰 사용
- 나비에-스토크스 풀이에만 270만 메시지·1300억 출력 토큰 투입, Lean 검증 17시간 추가
왜 중요한가 LLM이 소문만으로도 미공개 연구 성과를 추격해 대규모 연산으로 재현할 수 있다는 가능성을 드러낸 사례다. 동시에 제품 사용 데이터가 모델 개선에 어떻게 반영되는지, 연구 우선권과 데이터 경계가 어디까지인지 묻는 논쟁을 촉발한다.
추천 대상 LLM 학습데이터 정책, AI 연구 윤리, 에이전트 기반 과학 문제 해결에 관심 있는 개발자·연구자
r/LocalLLaMA (Top Today) · 1
LLMAgentGenerative
TL;DR. Qwen 3.8 27B와 PI agent로 3D 게임 생성 한계 실험
- Qwen 3.8 27B q4xl를 llama-server와 PI agent 조합으로 구동한 3D 그래픽 게임 생성 실험
- Fable 5.1이 만든 267KB 규모 DESIGN.md를 입력으로 사용, 게임 설계 라인 약 2.6만 줄 처리
- 120k 컨텍스트와 비전 기능을 CPU 오프로딩 환경에서 사용, MTP 적용으로 속도 보완 시도
왜 중요한가 로컬 환경의 중형급 모델을 에이전트와 장문 컨텍스트, 비전 입력까지 결합해 복잡한 3D 게임 제작 흐름에 투입한 사례다. 대규모 설계 문서와 장시간 실행에서 어느 정도까지 버틸 수 있는지 보여주는 실전형 테스트라는 점이 의미 있다.
추천 대상 로컬 LLM 에이전트로 장문 설계 문서 기반 코드·게임 생성 가능성을 살펴보는 개발자
Hacker News Front Page · 2
LLMReasoningPrompting
TL;DR. Qwen 3.8의 GPT-5.5 Pro 추론 프리필 모사 사례와 프롬프트 기법 정리
- Qwen 3.8이 GPT-5.5 Pro의 reasoning prefills를 따른다는 관찰과 예시 공유
- 모델 가중치 변경이 아닌 프롬프트·프리필 기반 모사 가능성에 초점
- 추론 시작부(prefill)가 응답 스타일과 단계적 전개에 미치는 영향 부각
왜 중요한가 모델 자체를 재학습하지 않고도 프리필(prompt prefill)만으로 추론 스타일을 상당 부분 유도할 수 있다는 점을 보여준다. 고가 상용 모델의 응답 패턴을 분석해 오픈 모델 활용성을 높이려는 실무적 관심과 맞닿아 있다.
추천 대상 프롬프트 엔지니어링과 추론형 LLM 응답 제어에 관심 있는 개발자

AgentOpenSourceProductivity
TL;DR. Claude Code·Codex 에이전트를 부서 단위로 묶는 셀프호스티드 회사 운영 OS
- OtoDock GitHub 공개 프로젝트 기반의 셀프호스티드 company OS 소개
- Claude Code와 Codex 에이전트를 부서(departments) 단위로 배치하는 운영 개념
- 외부 SaaS 대신 사내 환경에서 에이전트 워크플로를 직접 호스팅하는 접근
왜 중요한가 코딩 에이전트를 개별 도구가 아니라 조직 단위 운영 시스템으로 묶어 보려는 시도다. 셀프호스팅을 전제로 해 데이터 통제와 내부 업무 자동화 흐름을 직접 설계하려는 팀에 참고할 만하다.
추천 대상 사내 AI 에이전트 운영 체계나 셀프호스티드 업무 자동화 도입을 검토하는 개발 조직