| TH—NEWS |
Morning Digest — 2026-09-09
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 코딩 에이전트 실사용 팁과 모델 추론/배포 효율 얘기가 같이 올라와서, 바로 써먹을 거리와 방향성 체크용 읽을거리가 반반 섞여 있어요. 당장 현업 감각으로 훑으려면
my-free-code: Claude Code와 Codex 등 코딩 에이전트 9종이 모델 설정을 공유하는 로컬 게이트웨이, Mercury 2.5, Unlocking Lossless Speedups in LLMs via Discrete Diffusion 이 세 개부터 보면 충분합니다.
🔥 꼭 볼 것
| 01 |
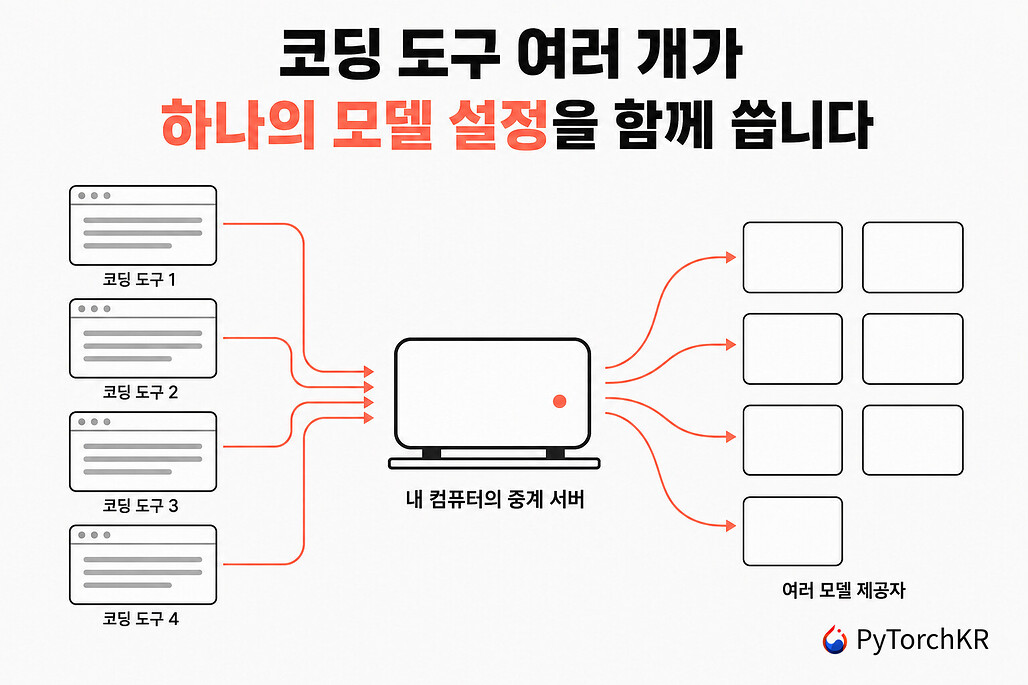 my-free-code: Claude Code와 Codex 등 코딩 에이전트 9종이 모델 설정을 공유하는 로컬 게이트웨이 여러 코딩 에이전트가 같은 로컬 모델 설정을 쓰게 해주는 실용 게이트웨이.
💡 에이전트 운영 복잡도를 바로 줄일 수 있음
|
| 02 | |
| 03 |
Unlocking Lossless Speedups in LLMs via Discrete Diffusion
품질 손실 없이 LLM 추론을 더 빠르게 만드는 이산 확산 샘플링 방법 제안.
💡 추론 비용과 지연 최적화 힌트를 줌
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | ayghri/i-have-adhd | 코딩 에이전트 답변을 ADHD 친화형으로 압축하는 출력 스킬 저장소 |
| PyTorch KR | GitReverse: 공개 GitHub 저장소를 바이브 코딩용 프롬프트 한 개로 되돌리는 웹 도구 어제 | 공개 GitHub 저장소를 코딩 에이전트용 한 문단 프롬프트로 되돌리는 웹 도구 |
| AI Lab Blogs | How GPT-5.6 Sol helps run quantum computing experiments | GPT-5.6 Sol·Codex로 양자컴퓨팅 실험 자동 수행·분석 사례 |
| Simon Willison's Weblog | llm 0.35 어제 | llm 0.35 릴리스와 OpenAI 신규 모델 gpt-6-astra 지원 추가 |
| r/LocalLLaMA (Top Today) | OpenAI alleged of stealing mathematicians work 어제 | 수학자 초안·대화의 Codex 유입과 OpenAI 모델 학습 연루 의혹 제기 |
| Hacker News Front Page | Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collaps… 어제 | Qwen3.8 27B 양자화 벤치마크: 4비트 유지, 1비트 붕괴 |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GeekNews | Cursor Origin API changelog가 하루 만에 자기 말을 뒤집었고, 두 항목 다 아직 살아있음 어제 | Cursor Origin API 변경로그의 상충 공지와 실제 기능 존속 확인 |
📚 전체 목록 (소스별)
GitHub Trending · 1
ayghri/i-have-adhd
Python · 422 stars today · ⭐ 29,990
AgentProductivityTooling
TL;DR. 코딩 에이전트 답변을 ADHD 친화형으로 압축하는 출력 스킬 저장소
- 코딩 에이전트가 핵심 답을 묻히지 않도록 출력 형식을 제어하는 스킬 제공
- ADHD 친화형 소비를 목표로 한 간결·우선순위 중심 응답 방식 지향
- GitHub Trending 기반 공개 저장소, Python 프로젝트로 높은 관심도 확인
왜 중요한가 에이전트 기반 코딩 도구는 장황한 설명으로 핵심 실행 항목이 뒤로 밀리는 문제가 잦다. 이 저장소는 모델 자체보다 출력 규율에 초점을 맞춰, 응답 가독성과 실행 가능성을 높이려는 접근이라는 점에서 의미가 있다.
추천 대상 코딩 에이전트 프롬프트·출력 스타일 최적화에 관심 있는 개발자와 AI 엔지니어
PyTorch KR 읽을거리 · 2
CodingAgentTooling
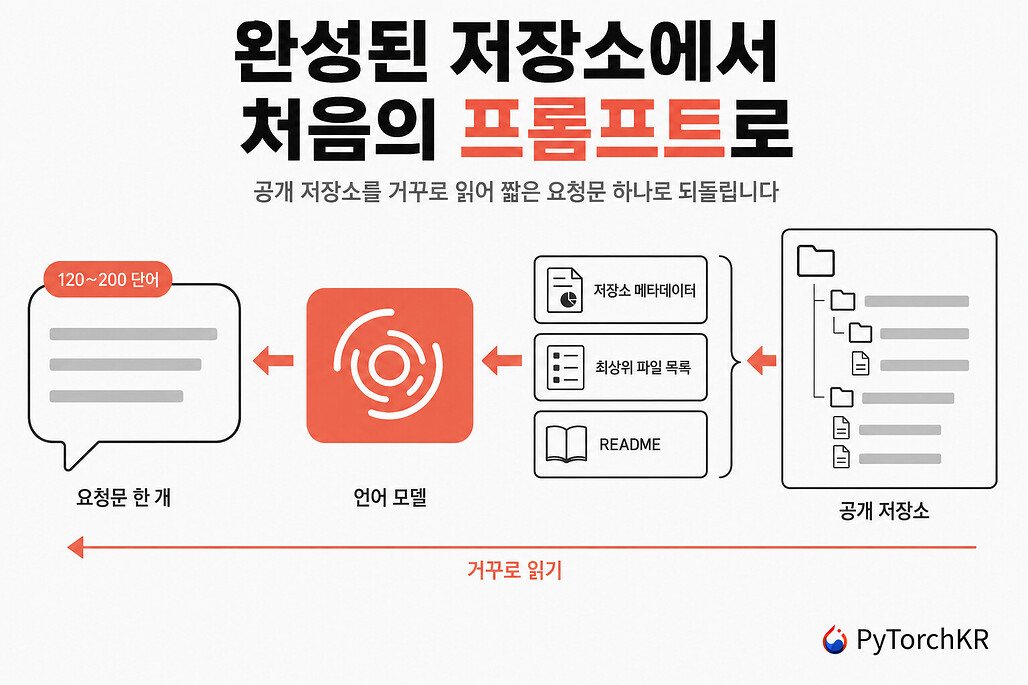
TL;DR. 공개 GitHub 저장소를 코딩 에이전트용 한 문단 프롬프트로 되돌리는 웹 도구
- 공개 저장소 URL이나 owner/repo 입력 시 Cursor, Claude Code, Codex, v0용 합성 사용자 메시지 1개 생성
- 입력 맥락은 저장소 메타데이터, 깊이 1 파일 트리, README로 제한, 구현 코드는 읽지 않는 경량 분석 방식
- 시스템 프롬프트에서 120~200단어 길이, 패키지명·폴더 구조 나열 금지, 근거 없는 기능 추론 억제
왜 중요한가 기존 도구들이 저장소를 이해하거나 문서화하기 쉽게 바꾸는 데 초점을 둔 반면, GitReverse는 비슷한 프로젝트를 처음부터 만들기 위한 시작 프롬프트 생성에 초점을 둡니다. 저장소 전체를 LLM에 넣지 않고도 컨텍스트 사용량을 줄여 바이브 코딩의 초기 진입 장벽을 낮춘다는 점이 차별점입니다.
추천 대상 코딩 에이전트로 레퍼런스 저장소를 빠르게 재현·변형해 보고 싶은 개발자
AgentCodingTooling
TL;DR. Claude Code·Codex 등 9개 코딩 에이전트용 로컬 모델 설정 공유 게이트웨이
- Claude Code와 Codex를 포함한 9종 코딩 에이전트 간 모델 설정 공유용 로컬 게이트웨이 소개
- 에이전트별로 흩어진 모델 연결·설정 관리를 한 지점에서 처리하는 방식
- 여러 코딩 에이전트를 병행 사용할 때 설정 중복과 전환 비용을 줄이는 활용성
왜 중요한가 코딩 에이전트마다 모델 설정과 연결 방식을 따로 관리해야 하는 불편을 줄이는 접근이다. 여러 에이전트를 함께 쓰는 개발 환경에서 설정 일관성과 실험 효율을 높이는 데 의미가 있다.
추천 대상 여러 코딩 에이전트를 함께 쓰며 로컬 개발 도구 체인을 정리하려는 개발자
GeekNews 최신 · 1
ToolingAPITech
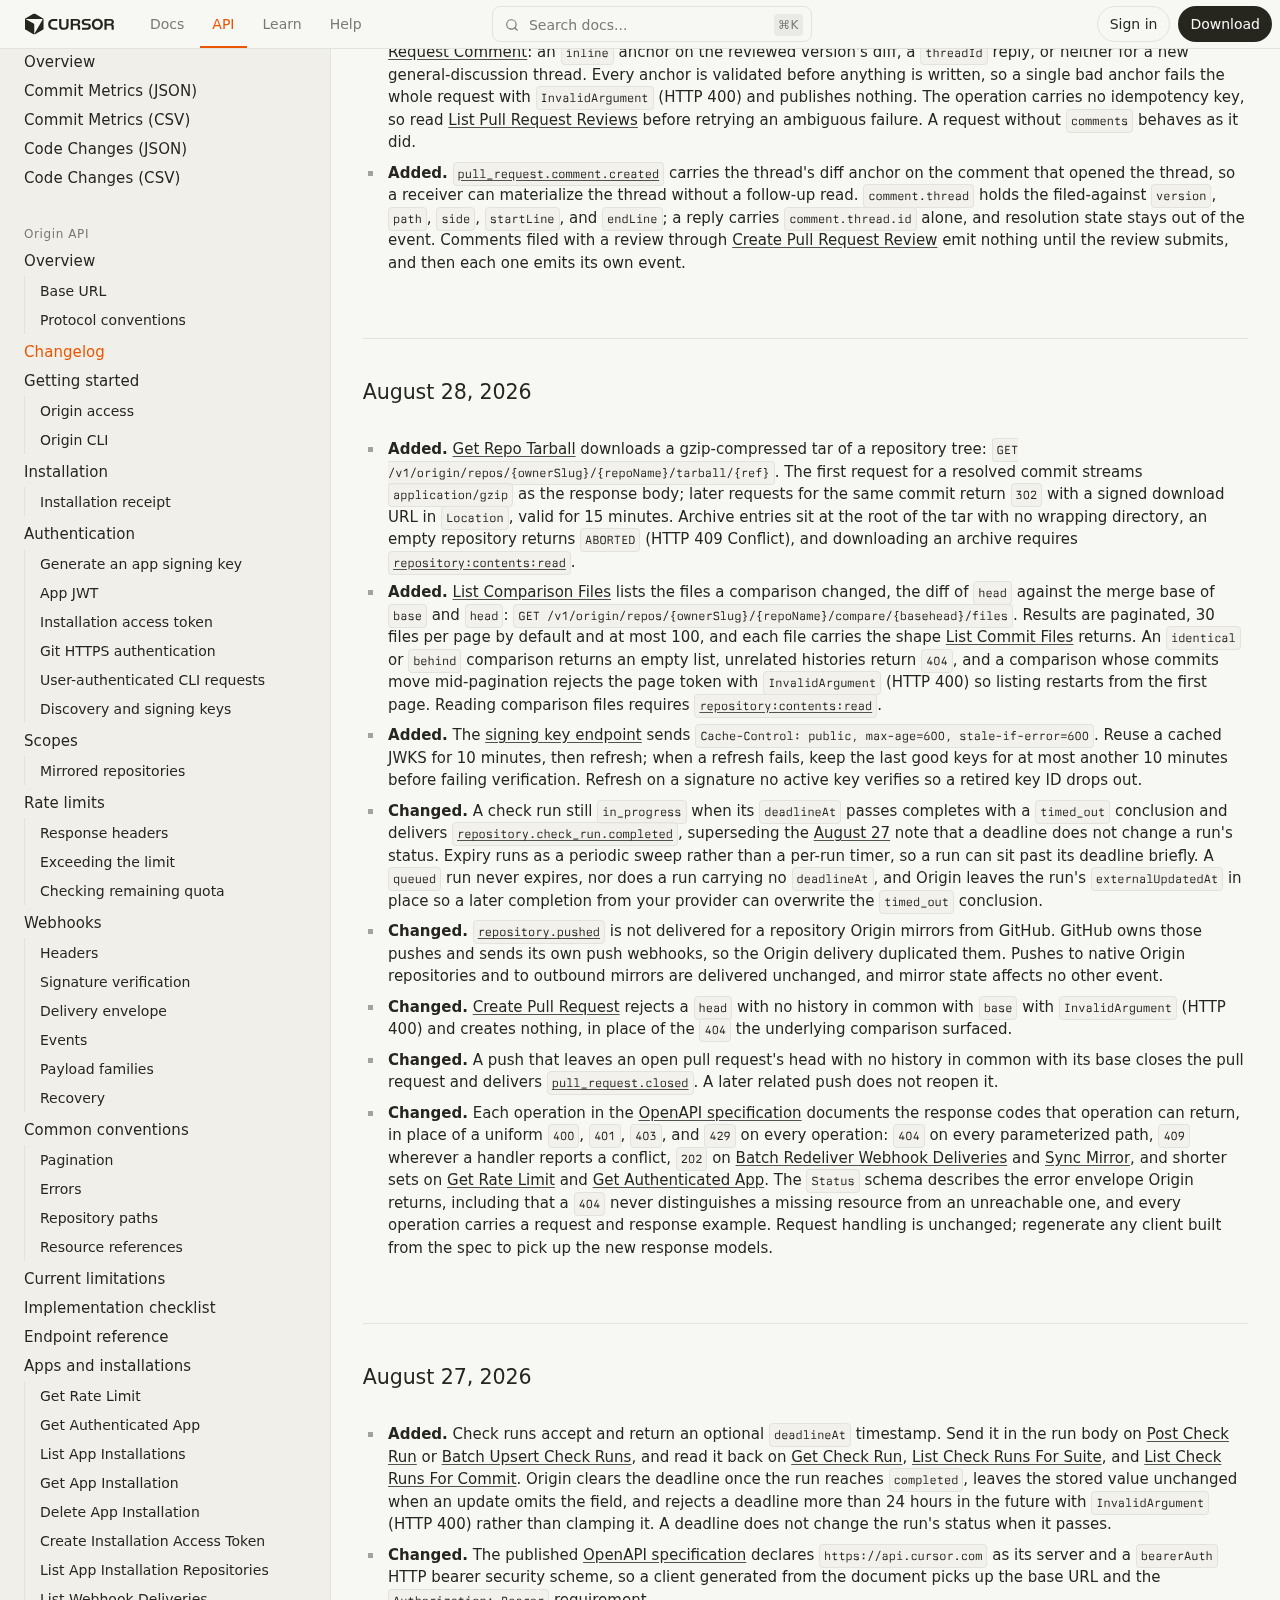
TL;DR. Cursor Origin API 변경로그의 상충 공지와 실제 기능 존속 확인
- Origin은 Cursor의 Git forge로 2026년 8월 17일 베타 공개
- API changelog에서 하루 차이로 정반대 내용의 항목 2건 확인
- 8월 27일 항목과 다음 날 항목이 check runs 관련 상태를 다르게 안내
왜 중요한가 개발자 도구의 변경로그는 통합 안정성과 마이그레이션 판단의 기준인데, 상충된 공지는 실제 운영 혼선을 키울 수 있다. 문서상 폐기·변경 안내와 실제 동작 상태가 다를 수 있음을 보여주는 사례다.
추천 대상 Git forge·개발자 플랫폼 API 변경 추적과 CI 연동 안정성에 민감한 엔지니어
HuggingFace Daily Papers · 1
LLMInferenceResearch
TL;DR. 이산 확산으로 LLM 추론을 무손실 가속하는 샘플링 방법 제안
- LLM 추론 가속 문제에 이산 확산(discrete diffusion) 기반 접근 적용
- 출력 품질 저하 없이(lossless) 속도 향상을 목표로 한 방법론 제시
- 자기회귀 생성 대안으로 확산형 토큰 생성 절차를 활용하는 연구 맥락
왜 중요한가 LLM 서비스의 병목은 주로 느린 자기회귀 디코딩에 있다. 이 연구는 정확도를 희생하지 않는 무손실 가속을 목표로, 기존 추론 최적화와 다른 이산 확산 기반 대안을 제시한다.
추천 대상 LLM 추론 최적화와 대체 디코딩 방식에 관심 있는 ML 엔지니어
AI Lab Blogs · 1
AgentCodingResearch
TL;DR. GPT-5.6 Sol·Codex로 양자컴퓨팅 실험 자동 수행·분석 사례
- MIT 연구자의 GPT-5.6 Sol·Codex 활용 사례 중심의 양자컴퓨팅 실험 자동화 소개
- 실험 실행, 결과 분석, 큐비트(qubit) 보정(calibration)까지 자율 처리 흐름 제시
- 코드 생성·실행 기반 에이전트형 워크플로로 연구 반복 작업 단축 가능성 시사
왜 중요한가 양자컴퓨팅 실험은 장비 제어, 반복 실행, 결과 해석, 보정이 얽혀 작업 부담이 크다. GPT-5.6 Sol과 Codex를 연구 워크플로에 연결해 실험 운영 자동화 가능성을 보여준 사례라는 점이 핵심이다.
추천 대상 연구 자동화, 에이전트 기반 실험 운영, 코드 실행형 AI 도구에 관심 있는 ML·연구 엔지니어
Simon Willison's Weblog · 1
llm 0.35 어제
LLMTooling
TL;DR. llm 0.35 릴리스와 OpenAI 신규 모델 gpt-6-astra 지원 추가
- CLI 도구 llm 0.35 버전 릴리스
- OpenAI 신규 모델 gpt-6-astra 지원 추가
- GPT-6 Astra 계열 모델 사용 경로 반영
왜 중요한가 로컬 CLI 기반 LLM 활용 도구가 최신 OpenAI 모델을 빠르게 따라간다는 점이 핵심이다. 새 모델 지원 추가만으로도 프롬프트 테스트와 자동화 워크플로 전환 비용을 낮출 수 있다.
추천 대상 CLI 기반 LLM 활용과 OpenAI 최신 모델 추적에 관심 있는 개발자
r/LocalLLaMA (Top Today) · 1
LLMSecurityPrivacy
TL;DR. 수학자 초안·대화의 Codex 유입과 OpenAI 모델 학습 연루 의혹 제기
- 두 수학자가 1년간 난제 풀이 초안 전부를 Codex에 입력했다는 주장
- 논문 공개 직전 OpenAI가 동일한 해법을 제시했다는 시점상 의혹 제기
- Sol·Astra가 개인 대화나 비공개 초안으로 학습됐는지 질문에 답변 부재 언급
왜 중요한가 LLM 사용 과정에서 입력한 비공개 연구 자료가 학습이나 재사용에 반영될 수 있는지에 대한 신뢰 문제를 드러낸다. 특히 연구·기업 기밀을 모델에 넣는 워크플로의 위험과 데이터 처리 투명성 요구를 다시 부각한다.
추천 대상 사내 기밀·연구 데이터를 LLM에 입력하는 정책을 고민하는 ML 엔지니어와 연구자
Hacker News Front Page · 2
LLMInferenceAgent
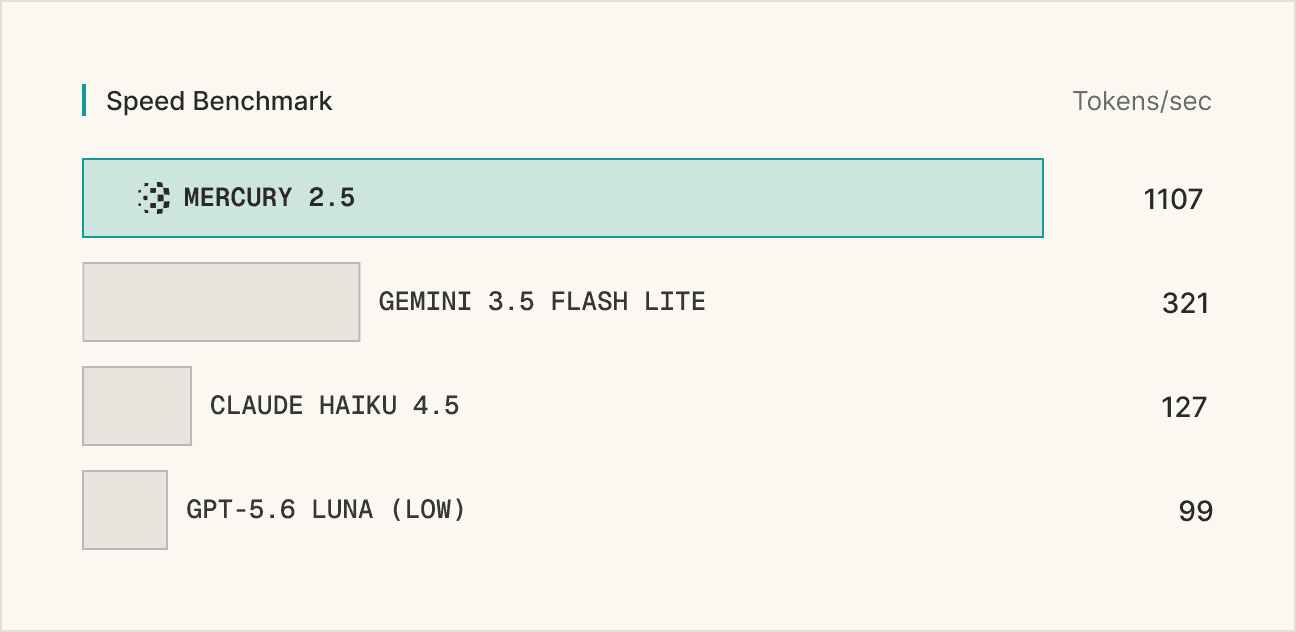
TL;DR. Mercury 2.5 공개, 확산형 LLM의 저지연·저비용 유지한 성능 상향
- Mercury 2 대비 지능 40% 향상, GPT-5.6 Luna Low·Gemini 3.5 Flash-Lite·Claude Haiku 4.5급 비교 제시
- 확산형 언어모델(dLLM) 기반, 260K 컨텍스트·초당 1,107토큰·NVIDIA GPU 기준 저지연 서빙 프로파일 강조
- 가격은 입력 100만 토큰당 0.20달러·출력 0.75달러, 출시 시점 80% 할인으로 0.04달러·0.15달러 제공
왜 중요한가 벤치마크 중심이 아니라 실제 운영 워크로드와 실패 사례를 학습·평가 루프에 반영해 품질을 끌어올린 점이 핵심이다. 저지연·저비용이 중요한 검색, 음성, 코딩 보조 시나리오에서 확산형 LLM의 실서비스 가능성을 보여준다.
추천 대상 지연 민감형 LLM 서빙, 음성 에이전트, 검색·코딩 에이전트 최적화에 관심 있는 ML 엔지니어
LLMInferenceBenchmark
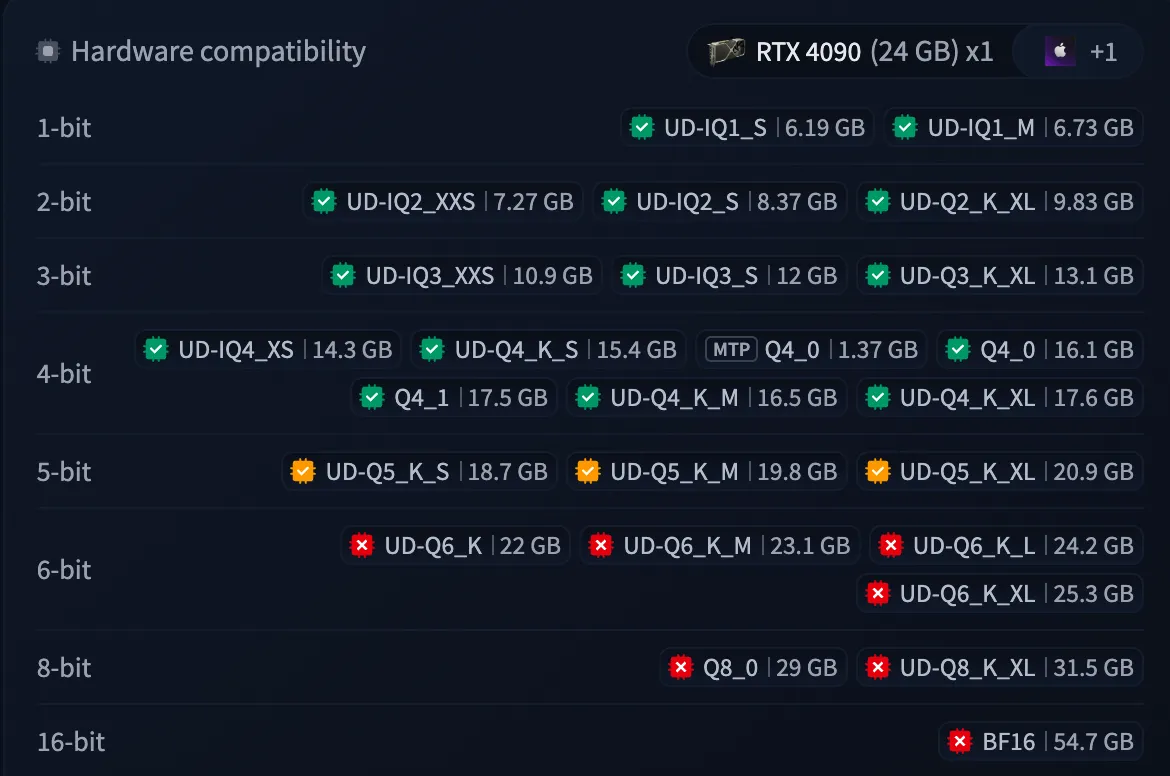
TL;DR. Qwen3.8 27B 양자화 벤치마크: 4비트 유지, 1비트 붕괴
- BF16 55GB 대비 Q4_K_M 17GB가 Terminal-Bench 2.1에서 동일 수준 성능, RTX 4090 24GB 탑재 가능
- 비교 대상은 Q8_0 29GB, Q4_K_M 17GB, UD-Q2_K_XL 10.7GB, UD-IQ1_S 6.2GB의 GGUF 양자화
- GPQA Diamond·IFBench에서 4비트까지 성능 차이 미미, 2비트는 소폭 하락, 추론 effort 설정 영향 큼
왜 중요한가 로컬에서 대형 모델을 돌릴 때 VRAM 절감과 성능 유지의 경계가 어디인지 실측으로 보여준다. 단순 토큰 유사도 대신 GPQA, IFBench, Terminal-Bench로 평가해 실사용 기준의 양자화 한계를 확인한 점이 핵심이다.
추천 대상 로컬 LLM 배포, GGUF 양자화, 소비자 GPU 추론 성능에 관심 있는 ML 엔지니어