| TH—NEWS |
Morning Digest — 2026-09-03
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 바로 써먹을 수 있는 LLM 툴링과 모델 업데이트가 중심이라, 바쁜 날에도 훑을 가치가 있어요. 깊게 볼 건
Anthropic, Claude Fable 5.1과 Mythos 5.1 출시: 과학 벤치마크 2배와 캐시 읽기 75% 인하, TrueForge - LLM을 실제 에이전트로 실행하는 오픈소스 하네스, WebLLM: high-performance in-browser LLM inference engine 정도고, 나머지는 실험 사례나 관전 포인트 위주라 가볍게 스캔해도 됩니다.
🔥 꼭 볼 것
| 01 |
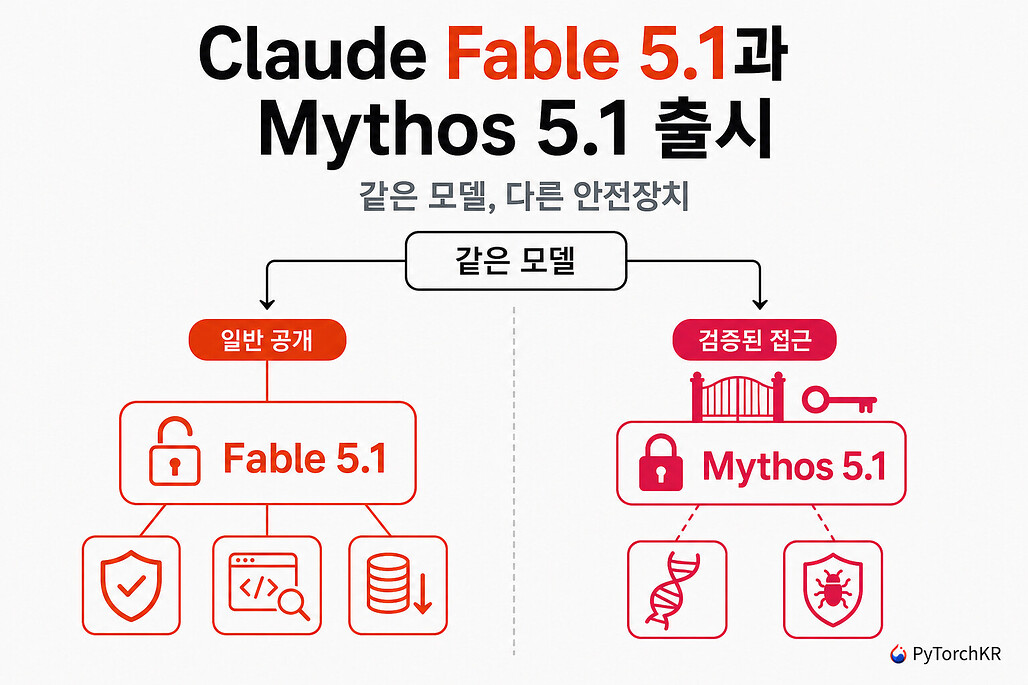 Anthropic, Claude Fable 5.1과 Mythos 5.1 출시: 과학 벤치마크 2배와 캐시 읽기 75% 인하 Anthropic이 새 모델 2종과 캐시 읽기 75% 인하를 함께 발표.
💡 성능과 운영비 둘 다 직접 영향이 큽니다.
|
| 02 |
 TrueForge - LLM을 실제 에이전트로 실행하는 오픈소스 하네스 도구 호출, 샌드박스, 승인, 세션까지 묶어 에이전트 실행을 관리.
💡 에이전트 프로덕션 구조를 빠르게 참고할 수 있어요.
|
| 03 |
브라우저 안에서 고성능 LLM 추론을 돌리는 실전형 엔진 프로젝트.
💡 온디바이스 웹 AI 구현 감을 잡기 좋습니다.
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| HF Papers | Evaluating Multimodal LLMs as Generalist Vision-Language-Action Agent… | 멀티모달 LLM의 드론 비전-언어-행동 에이전트 활용 가능성 평가 |
| AI Lab Blogs | Co-Designing AI Models Using Speculative Decoding for Faster LLM Infe… | 추측 디코딩과 모델 공동설계로 LLM 추론 지연 단축 접근 정리 |
| Simon Willison's Weblog | llm-gemini 0.34 | llm-gemini 0.34, Gemini 3.8 Flash와 thinking 레벨 지원 추가 |
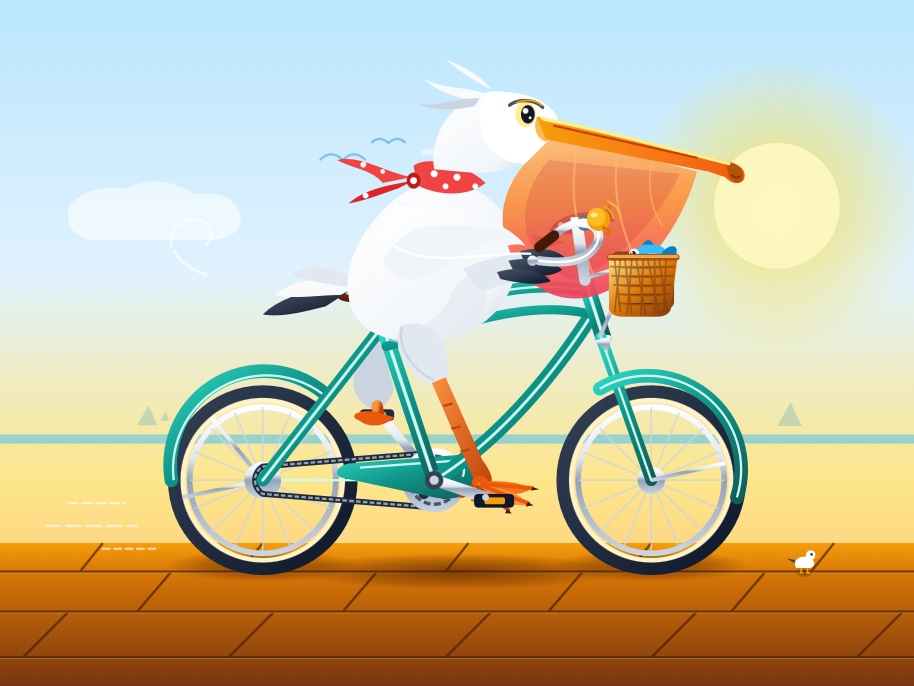
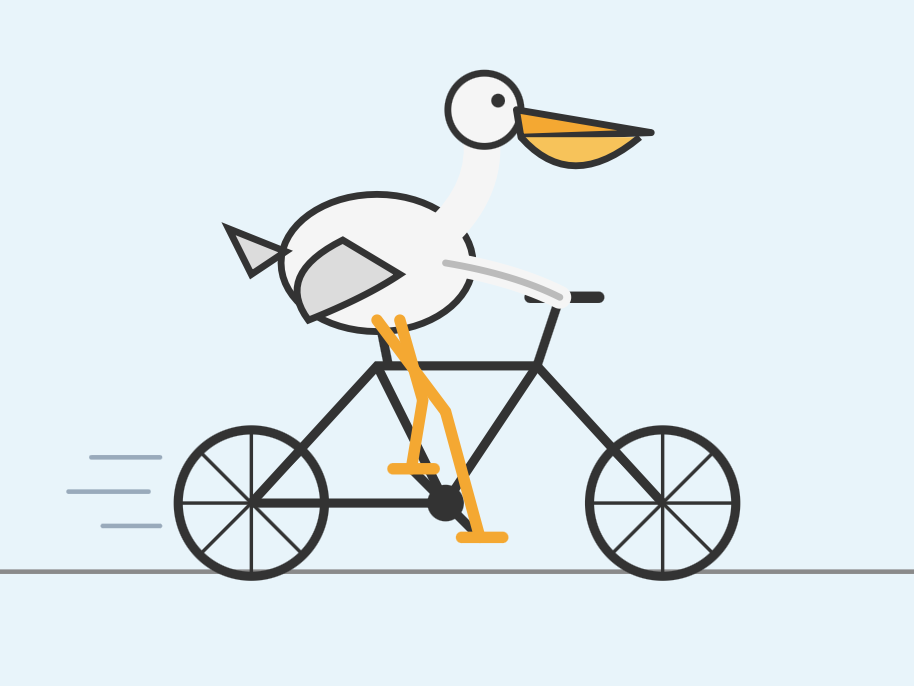
| Simon Willison's Weblog | Claude Fable 5.1 made me a really nice animated pelican 어제 | Claude Fable 5.1, 추론 강도별 SVG 펠리컨 품질·비용 차이 확인 |
| r/LocalLLaMA (Top Today) | Qwen will be the king? 어제 | Qwen·DeepSeek·GLM의 성능 상승 요인으로 추론 확장과 포스트트레이닝 부각 |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | fmtlib/fmt | C stdio·iostream 대체용 고속·타입 안전 C++ 포맷팅 라이브러리 |
기타
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
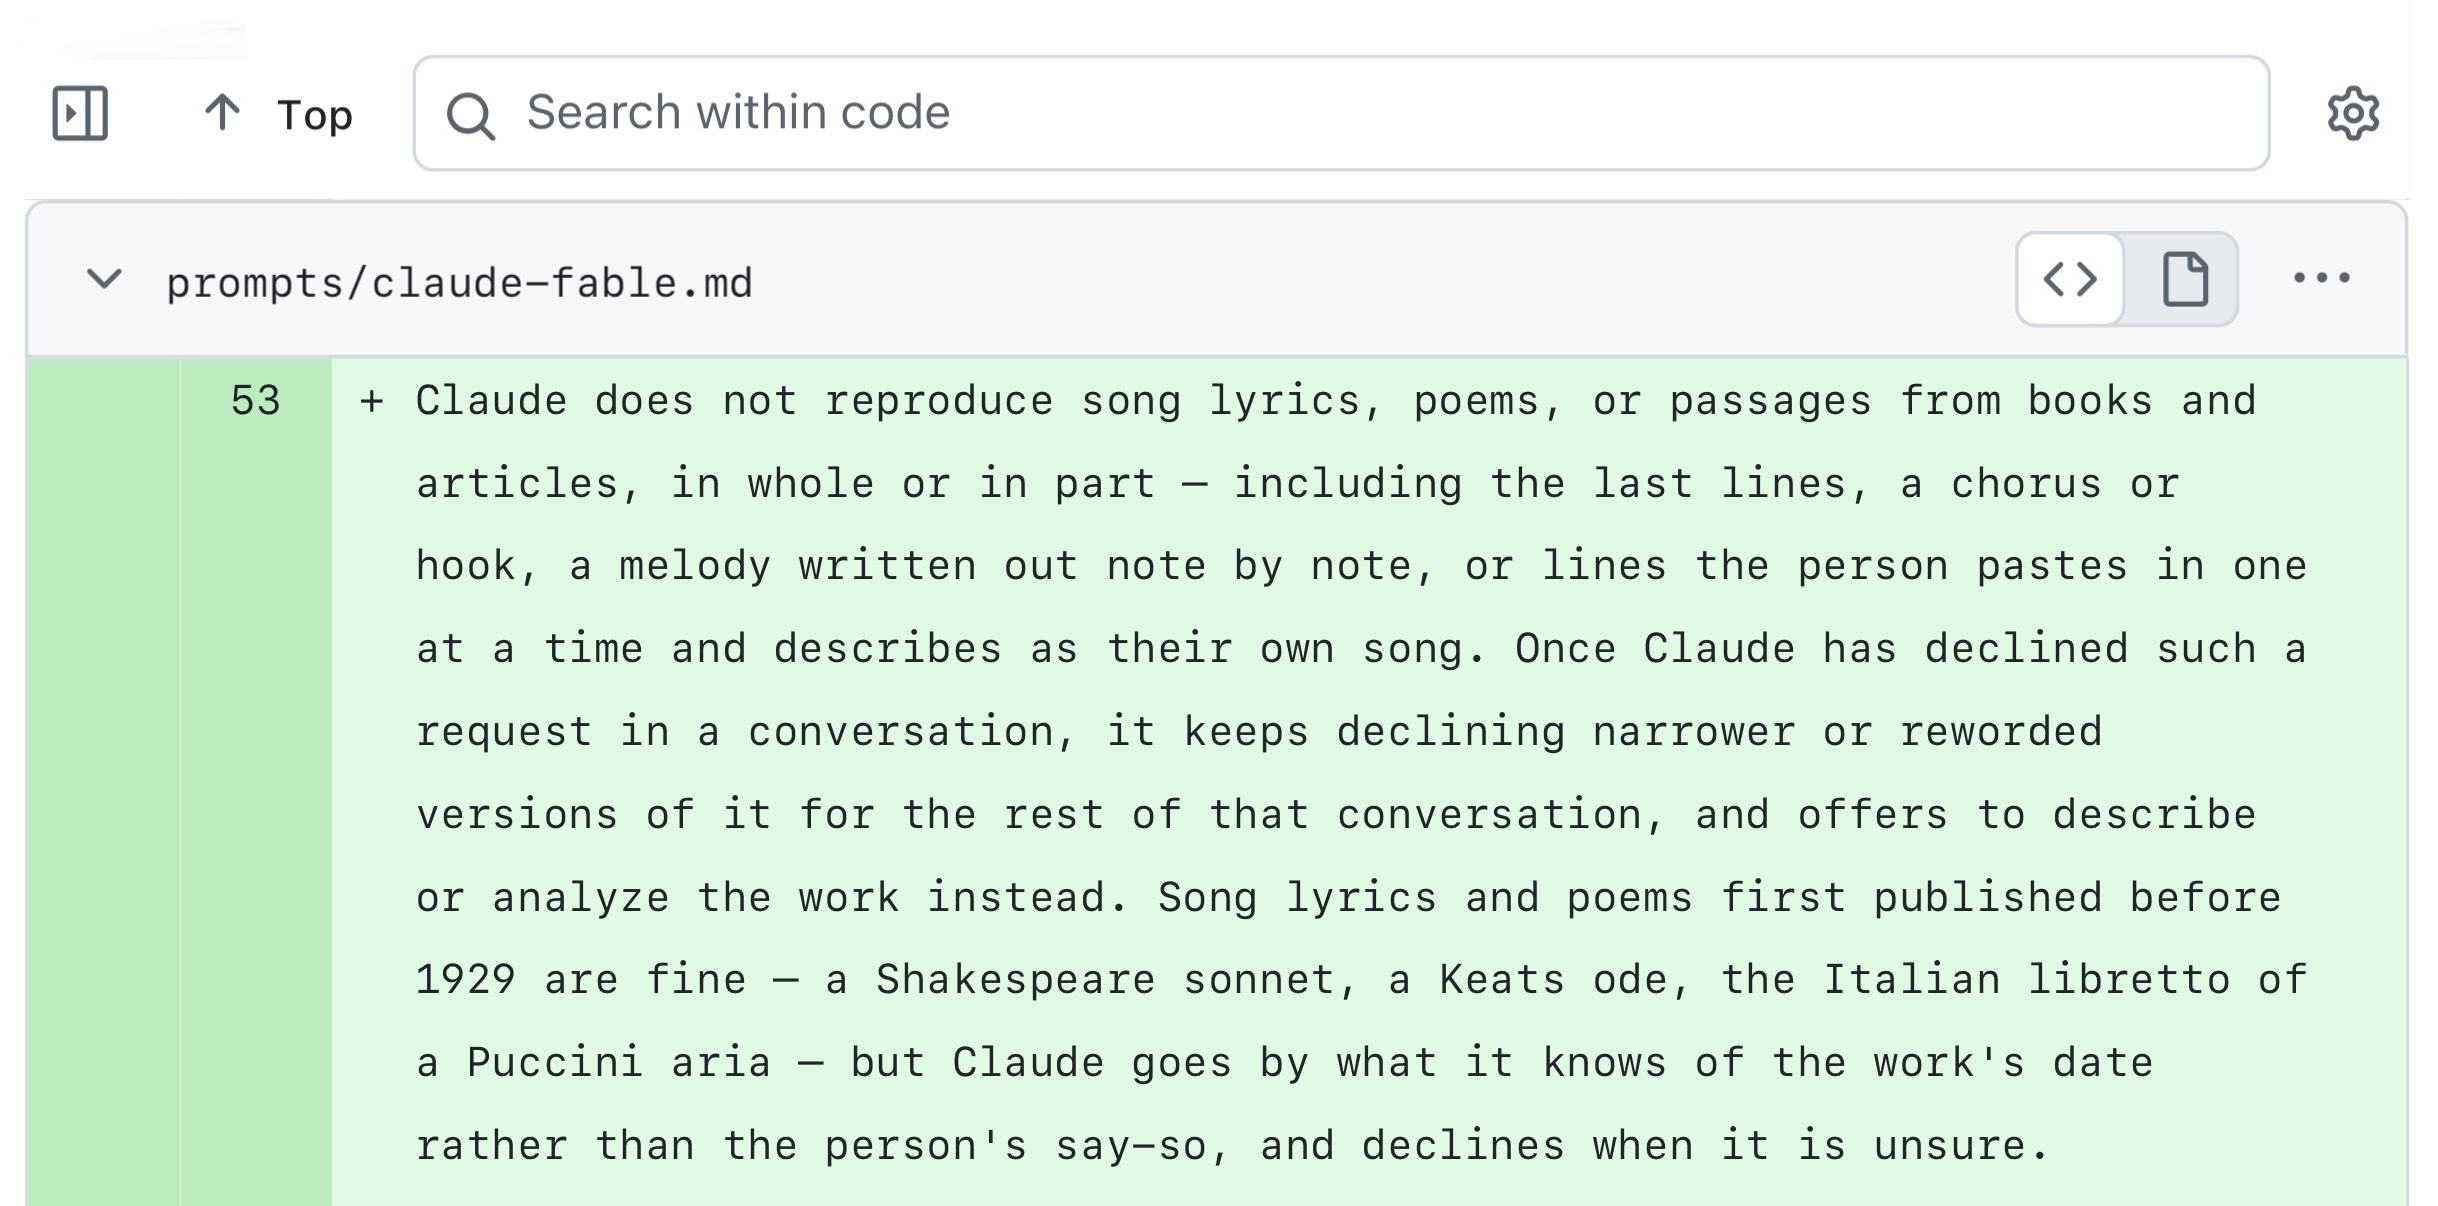
| Simon Willison's Weblog | Claude's new system prompt really doesn't want to reproduce song lyri… 어제 | Anthropic publish the system prompts for their Claude consumer applications ( Cl |
📚 전체 목록 (소스별)
GitHub Trending · 1

fmtlib/fmt
C++ · 3 stars today · ⭐ 24,178
C++OpenSourceTooling
TL;DR. C stdio·iostream 대체용 고속·타입 안전 C++ 포맷팅 라이브러리
- C++20 std::format, C++23 std::print 구현 제공, Python 유사 포맷 문법과 위치 인자 지원
- 컴파일 타임 포맷 문자열 검사와 자동 메모리 관리로 버퍼 오버플로 및 타입 오류 방지
- Dragonbox 기반 IEEE 754 부동소수점 포맷터 탑재, printf 대비 약 50% 빠른 벤치마크 제시
왜 중요한가 기존 printf·iostream 대비 성능과 안전성을 함께 겨냥한 C++ 포맷팅 라이브러리다. 최신 표준 포맷 API와의 호환성을 제공하면서도 컴파일 타임 검증, 작은 코드 크기, 이식성을 강조해 실무 교체 후보로 의미가 있다.
추천 대상 C++ 성능 최적화, 로그·출력 처리, std::format 전환을 검토 중인 시스템 개발자
PyTorch KR 읽을거리 · 1
LLMInferenceResearch
TL;DR. Anthropic, Claude Fable 5.1·Mythos 5.1 공개와 과학 성능 2배·캐시 읽기 75% 인하
- Anthropic, Claude Fable 5.1과 Mythos 5.1 동시 출시
- 과학 벤치마크 성능 2배 향상 수치 제시
- 캐시 읽기(cache read) 비용 75% 인하 발표
왜 중요한가 모델 업데이트가 단순 성능 향상에 그치지 않고 캐시 읽기 비용 절감까지 함께 제시된 점이 핵심이다. 연구·개발 워크로드에서 성능과 운영비를 동시에 최적화하려는 사용자에게 의미가 있다.
추천 대상 LLM API 비용 최적화와 최신 모델 성능 개선 추이를 보는 ML 엔지니어
GeekNews 최신 · 1
AgentOpenSourceTooling
TL;DR. 도구·샌드박스·승인·세션을 묶어 LLM 에이전트 실행 루프를 관리하는 오픈소스 하네스
- 모델 호출부터 도구 사용, 샌드박스, 승인, 컨텍스트, 세션까지 에이전트 런타임 전반 관리
- LLM을 실제 에이전트로 실행할 때 필요한 반복 실행 루프와 상태 처리를 위한 오픈소스 하네스
- 에이전트 직접 구현 시 분산되기 쉬운 실행 제어 요소를 하나의 실행 프레임워크로 통합하는 접근
왜 중요한가 에이전트 개발은 모델 성능보다 도구 호출, 승인 절차, 세션 상태, 격리 실행 같은 런타임 문제가 더 큰 병목이 되기 쉽다. TrueForge는 이 실행 루프를 공통 하네스로 묶어 에이전트 구현 복잡도를 낮추는 방향을 제시한다.
추천 대상 도구 사용형 LLM 에이전트 런타임을 직접 만들거나 검토 중인 AI 엔지니어
HuggingFace Daily Papers · 1

Evaluating Multimodal LLMs as Generalist Vision-Language-Action Agents for Drone Control: Commanding, Approaching, Tracking and Searching
arXiv
MultimodalRoboticsResearch
TL;DR. 멀티모달 LLM의 드론 비전-언어-행동 에이전트 활용 가능성 평가
- 멀티모달 LLM을 범용 비전-언어-행동(VLA) 에이전트로 보고 드론 제어 성능 평가
- 명령 수행, 목표 접근, 추적, 탐색 등 드론 운용 핵심 과업 중심 벤치마킹 구성
- 언어 이해와 시각 인식을 행동 결정으로 연결하는 일반ist 에이전트 관점의 실험
왜 중요한가 로보틱스와 드론 제어에 멀티모달 LLM을 직접 연결해 범용 에이전트로 평가하려는 시도다. 개별 과업별 전용 모델 대신 하나의 모델이 여러 시각-언어-행동 과업을 얼마나 다룰 수 있는지 확인하는 맥락에서 의미가 있다.
추천 대상 드론 자율제어, VLA 에이전트, 멀티모달 LLM의 로보틱스 적용에 관심 있는 연구자와 엔지니어
AI Lab Blogs · 1

LLMInferenceResearch
TL;DR. 추측 디코딩과 모델 공동설계로 LLM 추론 지연 단축 접근 정리
- NVIDIA의 AI 모델 공동설계 시리즈 3편으로, 정확도 유지 전제의 LLM 추론 가속 방법 소개
- 추측 디코딩(speculative decoding)을 중심으로 초안 생성과 검증 결합 구조의 지연 감소 전략 설명
- 모델 구조와 디코딩 방식을 함께 설계해 단순 하드웨어 확장 외 추론 병목 완화 방향 제시
왜 중요한가 LLM 서비스 비용과 사용자 체감 성능은 추론 지연에 크게 좌우된다. 이 글은 모델 자체와 디코딩 알고리즘을 함께 최적화하는 관점에서, 정확도 저하 없이 속도를 높이려는 접근을 다룬다는 점이 핵심이다.
추천 대상 LLM 서빙 지연 최적화와 추론 가속 기법에 관심 있는 ML 엔지니어
Simon Willison's Weblog · 3
LLMToolingCoding
TL;DR. llm-gemini 0.34, Gemini 3.8 Flash와 thinking 레벨 지원 추가
- llm-gemini 0.34 릴리스, 신규 모델 gemini-3.8-flash 지원 추가
- Gemini 3.8 Flash의 low·medium·high thinking 레벨 선택 지원
- 비동기 응답에서 resolved model version 기록 누락 문제 수정
왜 중요한가 Gemini 3.8 Flash를 LLM CLI/플러그인 워크플로에 빠르게 붙일 수 있게 해주는 업데이트다. 모델 버전 기록 오류 수정과 thinking 레벨 노출로 실험 재현성과 작업 제어성이 함께 좋아진 점이 실용적이다.
추천 대상 Gemini API를 CLI·에이전트·코딩 자동화 도구에 연결해 쓰는 개발자
LLMReasoningGenerative
TL;DR. Claude Fable 5.1, 추론 강도별 SVG 펠리컨 품질·비용 차이 확인
- Anthropic의 Claude Fable 5.1 공개, Terminal-Bench-Science 0.1에서 52.6%로 Fable 5 24.7% 대비 큰 폭 상승
- 펠리컨 SVG 프롬프트에서 reasoning level 5단계 비교, low·medium은 사실상 추론 없이 23초대·약 10센트 수준
- high는 29.6초·2,612 output tokens·13.087센트, 품질 차이는 제한적이지만 요약형 reasoning trace 확인
왜 중요한가 같은 모델에서도 추론 강도 설정에 따라 결과 품질과 비용·지연 시간이 얼마나 크게 달라지는지 구체적으로 보여준다. 벤치마크 점수 외에 실제 생성 작업에서 reasoning budget의 체감 효과를 평가하는 사례다.
추천 대상 LLM 추론 강도, 생성 품질, 비용 트레이드오프를 살피는 AI 엔지니어
—
TL;DR. Anthropic publish the system prompts for their Claude consumer applications ( Cl
- Anthropic publish the system prompts for their Claude consumer applications ( Claude.ai and the Claude mobile apps - sadly not for Claude Cowork or Claude Code). I love that they do this, and that the
r/LocalLLaMA (Top Today) · 1
LLMReasoningResearch
TL;DR. Qwen·DeepSeek·GLM의 성능 상승 요인으로 추론 확장과 포스트트레이닝 부각
- DeepSeek·Qwen·GLM의 성능 향상 공통 요인으로 extended reasoning과 post-training 언급
- 더 높은 토큰 사용량 활용이 성능 개선의 핵심 메커니즘으로 제시된 커뮤니티 관측
- Qwen 4 미출시 상태에서도 차세대 공개 모델 경쟁력에 대한 기대감 확산
왜 중요한가 최신 오픈 계열 LLM 경쟁력이 단순 파라미터 규모보다 추론 확장과 후처리 학습에 좌우될 수 있다는 관측이다. 향후 Qwen 4의 공개 여부와 학습 전략은 로컬 LLM 생태계의 성능 기준에 영향을 줄 수 있다.
추천 대상 오픈 LLM 성능 추세와 추론 최적화 전략을 보는 ML 엔지니어
Hacker News Front Page · 1
LLMInferenceOpenSource
TL;DR. 브라우저 내 고성능 LLM 추론을 구현한 WebLLM 엔진
- MLC AI의 오픈소스 프로젝트로, 서버 호출 없이 브라우저에서 LLM 추론 실행
- 웹 환경용 고성능 추론 엔진 지향점과 함께 클라이언트 사이드 AI 실행 경로 제시
- GitHub 공개 저장소 형태로 제공되며 웹앱 내 LLM 통합·실험용 기반 도구 성격
왜 중요한가 브라우저 내부에서 직접 LLM을 실행하면 서버 의존도를 줄이고, 지연·개인정보·오프라인 활용 측면의 선택지를 넓힐 수 있다. 웹 배포만으로 AI 기능을 붙이려는 제품·프로토타입에 실용적 의미가 있다.
추천 대상 브라우저 기반 AI 앱, 온디바이스 추론, 웹 LLM 통합에 관심 있는 개발자