| TH—NEWS |
Morning Digest — 2026-08-30
10 posts · 9 sources · ✓ 06:30 KST
제목 클릭 시 원문으로 이동
📌 오늘의 핵심 요약. 오늘은 로컬에서 얼마나 크게 돌릴 수 있나와 새 모델·추론 아이디어가 같이 들어온 날이에요. 바로 써먹을 건
Osmantic/ODS, Qwen 3.8 27B at 50 tok/s with 100k Context on a 16GB GPU! (beellama.cpp) 쪽이 눈에 띄고, Tencent Releases and Open-Sources Tencent Hy4 Preview나 CritICL: Inference-Time Weak-to-Strong Generalization from Small Language Model…
🔥 꼭 볼 것
| 01 |
 Tencent Releases and Open-Sources Tencent Hy4 Preview 770B 규모, 활성 49B, 1M+ 컨텍스트의 대형 오픈 모델 공개.
💡 오픈 모델 상한선과 장문맥 경쟁 구도를 바로 보여줍니다.
|
| 02 | |
| 03 |
Qwen 3.8 27B at 50 tok/s with 100k Context on a 16GB GPU! (beellama.cpp)
16GB GPU에서 27B 모델을 100k 컨텍스트로 돌린 실전 설정 공유.
💡 저사양 장비에서 대형 모델 운영 가능성을 가늠할 수 있습니다.
|
👀 관심 있으면 볼 것
LLM/Agent
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| PyTorch KR | WeMM-Embedding: 2B 모델로 8B 베이스라인을 넘어선 범용 멀티모달 임베딩에 대한 연구 어제 | 2B 규모로 8B 베이스라인을 앞선 범용 멀티모달 임베딩 연구 |
| GeekNews | 블랙박스 LLM의 크기를 재는 법 어제 | 희귀 사실 기억 여부로 비공개 LLM 파라미터 규모를 추정하는 방법 |
| HF Papers | CritICL: Inference-Time Weak-to-Strong Generalization from Small Lang… | 소형 LM 실패 모드로 추론 시점 대형 모델 성능을 끌어올리는 CritICL |
| HF Papers | CaRGo-T: Causal Reasoning Graph-of-Thought improves Multimodal Humor … | 인과 추론 그래프 기반 사고로 멀티모달 유머 이해 성능 개선 |
| HF Papers | CaSKG: Counterfactual-Causal Skill Graphs for Scalable Agent Skill Re… | 반사실·인과 그래프로 에이전트 스킬 검색 확장성을 높인 CaSKG |
Infra/MLOps
| 소스 | 제목 | 한줄 요약 |
|---|---|---|
| GitHub | kaifcodec/user-scanner | 이메일·사용자명 하나로 455개 벡터를 추적하는 OSINT 도구 |
| Simon Willison's Weblog | Just a rumour of a bug is enough to find a security exploit these days 어제 | 버그 소문만으로도 수분 내 익스플로잇이 시작되는 AI 보안 현실 |
📚 전체 목록 (소스별)
GitHub Trending · 2

Osmantic/ODS
Python · 35 stars today · ⭐ 4,857
LLMAgentOpenSource
TL;DR. PC·Mac·리눅스를 AI 서버로 바꾸는 통합 로컬 AI 스택
- PC, Mac, Linux 환경을 AI 서버로 전환하는 Python 기반 오픈소스 프로젝트
- LLM 추론, 채팅 UI, 음성, 에이전트, 워크플로, RAG, 이미지 생성 기능 통합
- 단일 도구에서 다양한 생성형 AI 기능을 함께 다루는 로컬 실행 지향 구성
왜 중요한가 여러 생성형 AI 기능을 개별 도구로 조합하던 구성을 하나의 로컬 서버 스택으로 묶는 접근이다. 개인 PC나 범용 OS 환경에서 추론·RAG·에이전트·이미지 생성을 함께 운영하려는 수요에 맞닿아 있다.
추천 대상 로컬 LLM·RAG·에이전트 통합 실행 환경을 찾는 개발자

kaifcodec/user-scanner
Python · 39 stars today · ⭐ 3,471
SecurityToolingAgent
TL;DR. 이메일·사용자명 하나로 455개 벡터를 추적하는 OSINT 도구
- 이메일 175+·사용자명 280+ 등 총 455+ 플랫폼 대상 계정 존재 여부와 디지털 풋프린트 수집
- 아바타·바이오·팔로워 수·UID·셀러 상태 등 풍부한 프로필 메타데이터 스크래핑 지원
- cross-scan 엔진으로 핸들·프로필 링크·노출 이메일을 재귀 탐색하며 2-hop 피벗 가능
왜 중요한가 단순 계정 열거를 넘어 이메일·사용자명을 시작점으로 메타데이터 수집과 피벗 탐색까지 자동화한 점이 차별점이다. MCP 연동으로 LLM 에이전트가 조사 흐름에 직접 들어갈 수 있어 보안 조사와 디지털 포렌식 자동화에 활용 여지가 크다.
추천 대상 OSINT 자동화·계정 연계 분석·보안 조사 도구에 관심 있는 보안 연구자와 AI 에이전트 개발자
PyTorch KR 읽을거리 · 1
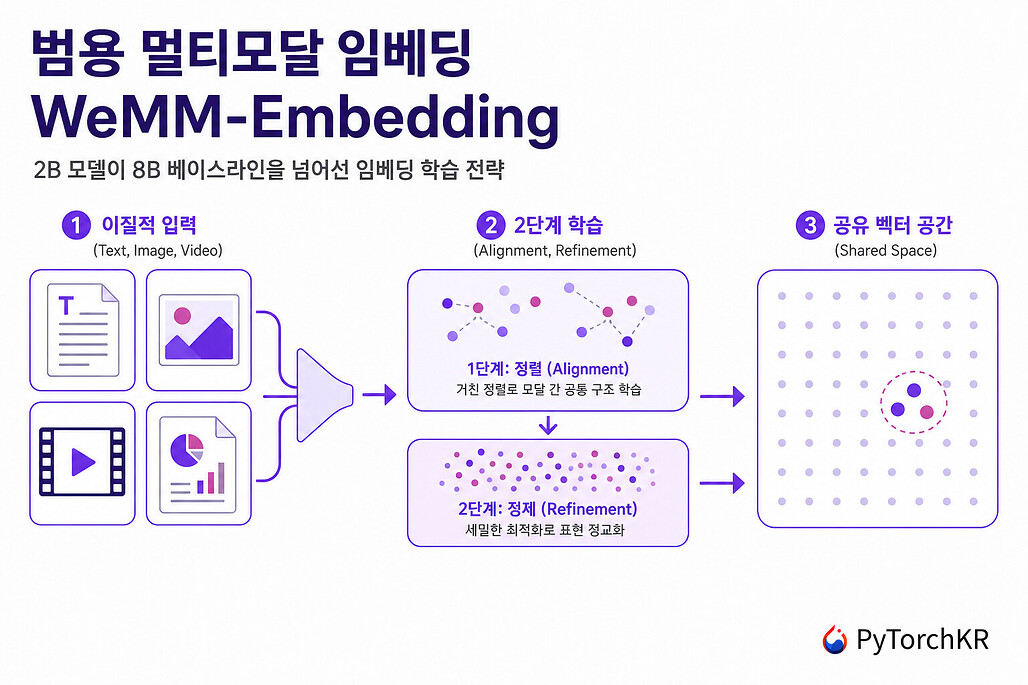
MultimodalEmbeddingResearch
TL;DR. 2B 규모로 8B 베이스라인을 앞선 범용 멀티모달 임베딩 연구
- WeMM-Embedding 중심의 범용 멀티모달 임베딩 연구 소개
- 2B 모델 규모에서 8B 베이스라인을 넘어서는 성능 결과 강조
- 텍스트·이미지 등 이종 모달리티를 함께 다루는 임베딩 접근
왜 중요한가 대형 멀티모달 모델이 성능 우위를 가진다는 통념에 대해, 더 작은 2B 모델로 8B 기준선을 넘는 결과를 제시한 점이 핵심이다. 임베딩 기반 검색·추천·정렬 같은 실무 영역에서 비용 대비 성능 개선 가능성을 보여준다.
추천 대상 멀티모달 검색·추천·표현학습 성능과 효율을 함께 보는 ML 엔지니어
GeekNews 최신 · 1
LLMBenchmarkResearch
TL;DR. 희귀 사실 기억 여부로 비공개 LLM 파라미터 규모를 추정하는 방법
- 모델이 학습 중 기억했을 가능성이 높은 희귀 사실(rare fact) 응답 패턴 기반의 크기 추정 접근
- 가중치·아키텍처 공개 없이 블랙박스 API 질의만으로 대략적 파라미터 규모를 역산하는 방법론
- 정답률 자체보다 장기 기억된 지식의 밀도와 희소성에 주목한 간접 측정 관점
왜 중요한가 폐쇄형 LLM은 파라미터 수와 학습 정보가 비공개인 경우가 많아 직접 비교가 어렵다. 이 접근은 외부에서 관찰 가능한 기억 특성을 이용해 모델 규모를 간접 추정하려는 시도로, 블랙박스 모델 분석과 비교 평가에 의미가 있다.
추천 대상 폐쇄형 LLM 평가·벤치마킹 방법에 관심 있는 AI 엔지니어
HuggingFace Daily Papers · 3

LLMReasoningResearch
TL;DR. 소형 LM 실패 모드로 추론 시점 대형 모델 성능을 끌어올리는 CritICL
- 소형 언어모델의 실패 모드(failure modes)를 활용한 inference-time weak-to-strong generalization 제안
- 학습이 아닌 추론 시점(inference-time)에 강한 모델의 응답 품질 향상을 노리는 접근
- 정답 예시보다 오류 패턴을 신호로 삼아 강한 모델의 추론을 보정하는 아이디어
왜 중요한가 보통 weak-to-strong 일반화는 학습 단계에 초점을 두지만, 이 연구는 추론 시점에 소형 모델의 '틀리는 방식'을 활용한다는 점이 다르다. 추가 학습 비용 없이 강한 모델의 취약한 추론 경로를 점검하는 방향으로 확장 가능성을 보여준다.
추천 대상 추론 최적화, LLM 평가·보정, weak-to-strong generalization에 관심 있는 AI 엔지니어

MultimodalReasoningResearch
TL;DR. 인과 추론 그래프 기반 사고로 멀티모달 유머 이해 성능 개선
- CaRGo-T(Causal Reasoning Graph-of-Thought) 제안, 멀티모달 유머 이해를 위한 구조화 추론 방식
- 텍스트·이미지 등 멀티모달 단서를 인과 관계 그래프로 연결해 유머의 맥락과 반전 해석 강화
- 단순 연쇄 추론(CoT) 대비 유머 이해처럼 암묵적 관계가 중요한 과제에 초점
왜 중요한가 유머 이해는 표면 정보보다 맥락, 상식, 반전의 인과 연결 해석이 중요하다. 이 연구는 멀티모달 입력을 그래프 형태의 인과 추론으로 다뤄, 기존 직렬형 추론의 한계를 보완하려는 접근이라는 점에서 의미가 있다.
추천 대상 멀티모달 추론, Graph-of-Thought, LLM 기반 고난도 이해 과제에 관심 있는 연구자·엔지니어

AgentReasoningResearch
TL;DR. 반사실·인과 그래프로 에이전트 스킬 검색 확장성을 높인 CaSKG
- Counterfactual-Causal Skill Graphs(CaSKG) 기반 에이전트 스킬 검색 프레임워크 제안
- 스킬 간 관계를 반사실(counterfactual)·인과(causal) 관점으로 구조화한 검색 방식
- 대규모 에이전트 환경에서 스킬 검색의 확장성(sc scalability) 개선에 초점
왜 중요한가 에이전트가 사용할 수 있는 스킬 수가 늘수록 적절한 도구·행동을 찾는 비용이 커진다. CaSKG는 단순 유사도 검색 대신 인과적 관계를 반영한 그래프 구조를 도입해, 더 큰 스킬 공간에서도 검색 품질과 확장성을 함께 다루려는 접근으로 보인다.
추천 대상 멀티스텝 에이전트 설계와 스킬·툴 검색 최적화에 관심 있는 AI 엔지니어
Simon Willison's Weblog · 1
SecurityOpenSourceAgent
TL;DR. 버그 소문만으로도 수분 내 익스플로잇이 시작되는 AI 보안 현실
- OCaml 프로젝트 패치 논의 공개 약 10분 만에 percent-encoded 경로 순회 탐침 관측
- 자동 감시자가 공개 저장소 변화를 추적하고, 코딩 에이전트가 단서만으로 취약점 재현 가능성 제기
- Anil Madhavapeddy, 자체 에이전트로 해당 가능성 시연, Claude Fable 거부 후 DeepSeek V4 Pro 사용 언급
왜 중요한가 취약점 패치 논의나 힌트만 공개돼도 AI 기반 탐색이 즉시 악용 시도로 이어질 수 있음을 보여준다. 공개 저장소 중심의 기존 보안 공개 절차와 엠바고 관행이 더 이상 충분하지 않을 수 있다는 문제 제기다.
추천 대상 오픈소스 유지보수자, 보안 대응 프로세스와 AI 에이전트 악용 리스크를 보는 개발자
r/LocalLLaMA (Top Today) · 1
LLMInferenceOpenSource
TL;DR. 16GB GPU에서 Qwen 3.8 27B를 100k 컨텍스트·50 tok/s로 구동한 설정 공개
- RTX 4070 Ti SUPER 16GB에서 Qwen3.8-27B를 장문 컨텍스트와 고속 추론으로 구동한 사례
- jrell의 Qwen3.8-27B-i1-IQ4_XS-GGUF-Smaller 사용, MTP와 100k 컨텍스트를 16GB VRAM에 맞춘 하이브리드 양자화
- beellama.cpp 기반 설정 공유, 품질 저하를 최소화하면서 VRAM 내 적재와 속도 확보가 목표
왜 중요한가 대형 모델의 장문 컨텍스트 추론을 소비자급 16GB GPU에서 구현한 사례라는 점이 핵심이다. 고가 GPU 없이도 27B급 모델과 100k 컨텍스트를 실사용 범위 속도로 다루려는 로컬 LLM 실험에 참고가 된다.
추천 대상 로컬 LLM 추론 최적화와 저VRAM 장문 컨텍스트 운용에 관심 있는 ML 엔지니어
Hacker News Front Page · 1
LLMOpenSourceInference
TL;DR. 텐센트, 770B·활성 49B·1M+ 컨텍스트 Hy4 Preview 오픈소스 공개
- 총 770B 파라미터, 활성 49B 구조와 100만 토큰 초과 컨텍스트 윈도 지원
- 코딩·오피스·과학 연구 등 생산성 작업 중심 설계, WorkBuddy·CodeBuddy·API로 제공
- 텐센트 내부 블라인드 평가에서 전문가 163명·공학 과제 203개 기준 평균 2.99점 기록
왜 중요한가 대규모 오픈소스 LLM 경쟁에서 생산성 실사용과 초장문 문맥 처리를 동시에 전면에 내세운 사례다. 모델이 자체 학습·추론 인프라 개선에 참여해 성능뿐 아니라 운영 효율까지 높였다는 점이 눈에 띈다.
추천 대상 오픈소스 LLM 비교, 장문 컨텍스트 활용, 추론 최적화에 관심 있는 ML 엔지니어